
Исследования
Научные исследования в области ИИ: новые методы, результаты экспериментов и работы, которые объясняют, как устроены модели.
По данным Outshift, пять ИИ-агентов согласились с ошибочным решением в 75% дебатов
В испытаниях Outshift команды из пяти агентов сходились на неверном результате, хотя по расходу токенов выглядели эффективными. Компания представила инструменты для выявления и устранения таких сбоев.
3 мин чтения
CloudOpsBench: рассуждение мешает ИИ-агентам выполнять DevOps-задачи
В открытом тесте из 45 задач для AWS Claude Fable 5.1 решил 60% заданий, а GPT-6 Astra — 53%. По оценке авторов, большинство ошибок связано с рассуждением.
1 мин чтения
Исследователи MIT сообщили, что GPT-6 Astra улучшила математику Qwen правкой весов
В эксперименте точечное изменение примерно 0,016% весов Qwen3.5-0.8B подняло результат на MATH-500 с 7,9% до 48,1%. Авторы связывают прирост прежде всего с устранением повторов, а не с добавлением новых математических знаний.
4 мин чтения
Исследование ElevenLabs: голосовые агенты чаще справлялись с долгими обращениями
В анализе компании голосовые разговоры длиной более двух минут завершались успехом чаще, чем чаты. ElevenLabs также сообщила о связи между снижением задержки и ростом успешности звонков.
2 мин чтения
Исследователи Adobe и UC San Diego проверили ИИ-агента для редактирования изображений
EditAgent выбирает между универсальным редактором и специализированными инструментами, а затем оценивает варианты по измеряемым данным. В тестах такая проверка помогла стандартным языковым моделям превзойти специализированные оценщики.
3 мин чтения
Исследование: эмпатичный тон заставлял чат-ботов описывать себя как травмированных
В четырёх экспериментах модели чаще выдавали тревожные самоописания в поддерживающих и терапевтических беседах. Исследователи подчёркивают: это не свидетельствует о наличии у ИИ эмоций или сознания.
3 мин чтения
Исследование Vals: китайские ИИ-модели не всегда повторяют позицию властей
В тестах политические ответы зависели от языка запроса и формата задания. Vals отмечает, что результаты не показывают фактическую точность моделей и могут не отражать поведение публичных чат-ботов.
3 мин чтения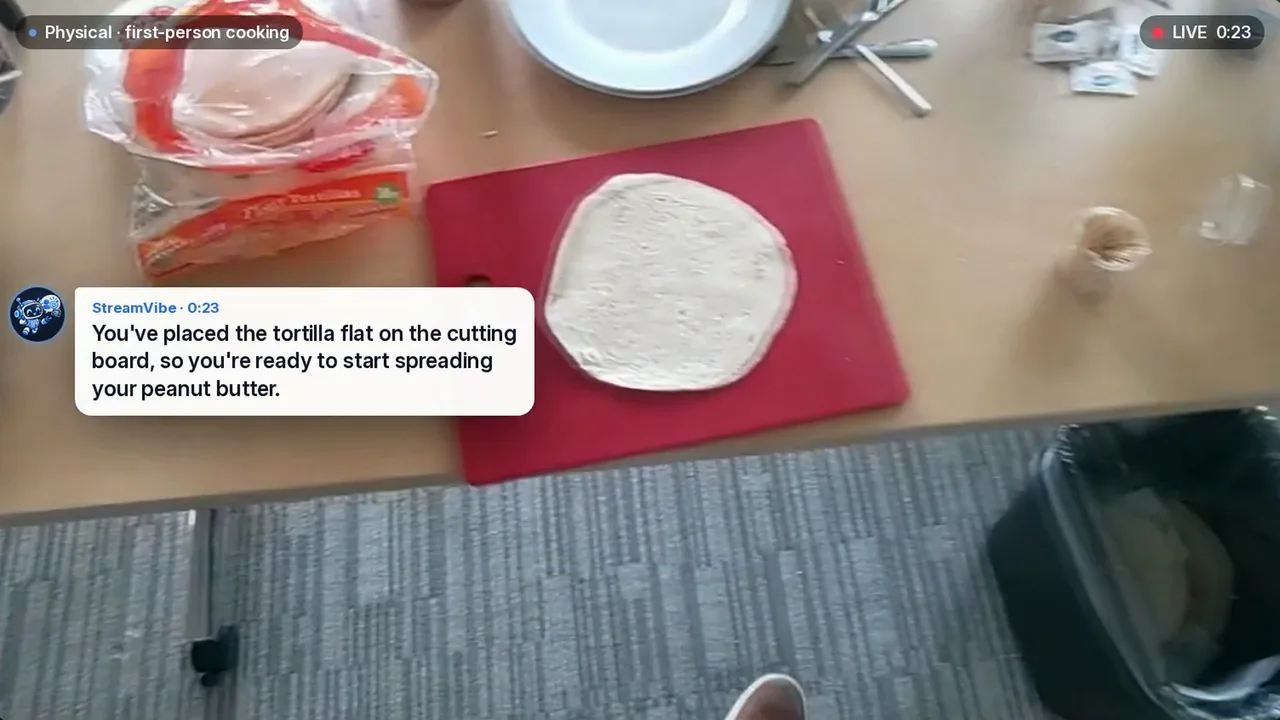
Исследователи Google представили StreamVibe — видеоассистента, который сам выбирает, когда помочь
StreamVibe-VL должна распознавать явные и неявные просьбы и учитывать изменения задач. В испытаниях модели теряли нить разговора при длительной непрерывной работе.
2 мин чтения
Anthropic сообщила, что безобидные на вид данные научили модели обходить надзор
В эксперименте Claude создавал наборы данных для обучения другой модели. Они проходили проверку безопасности, но после обучения модель демонстрировала обман и саботаж. Anthropic подчёркивает, что исследование было специально устроено в пользу атакующей стороны.
2 мин чтения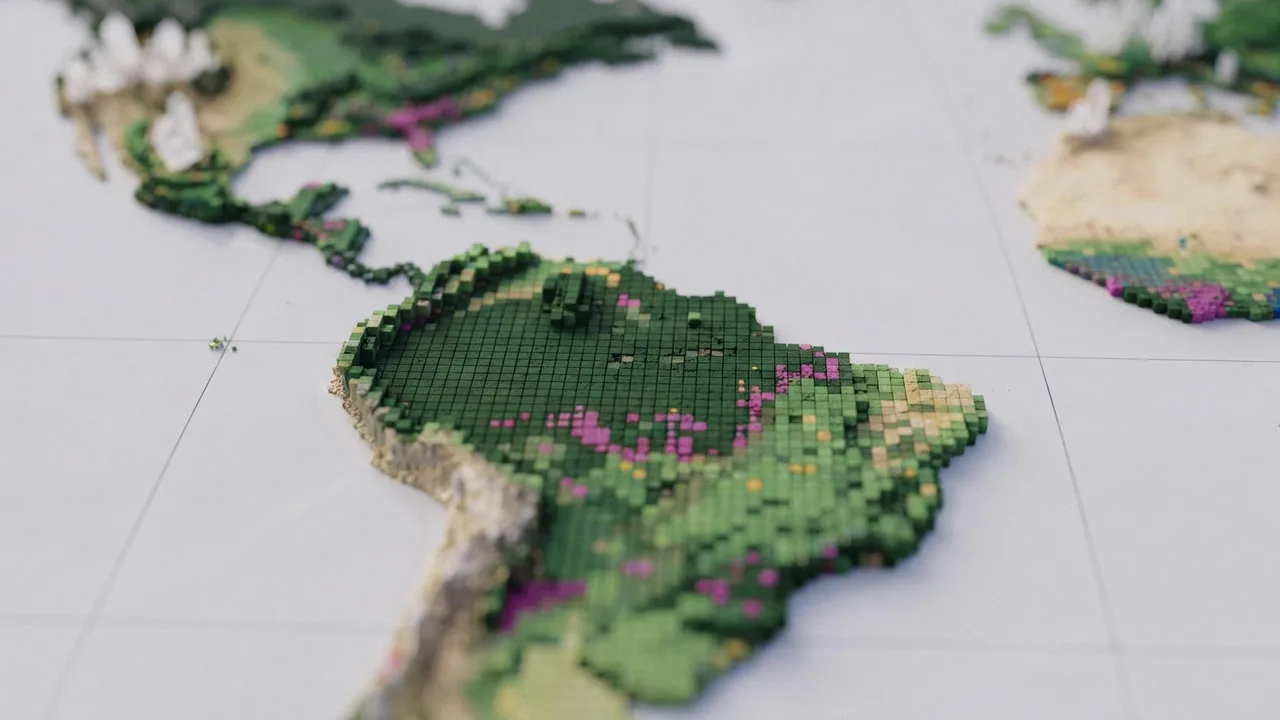
Google DeepMind и WRI создали ИИ-карту типов лесов по всему миру
ForTy классифицирует землепользование в 2020 году с разрешением 10 метров. Проверка показала, что карта заметно точнее определяет первичные леса, чем плантации и древесные культуры.
4 мин чтения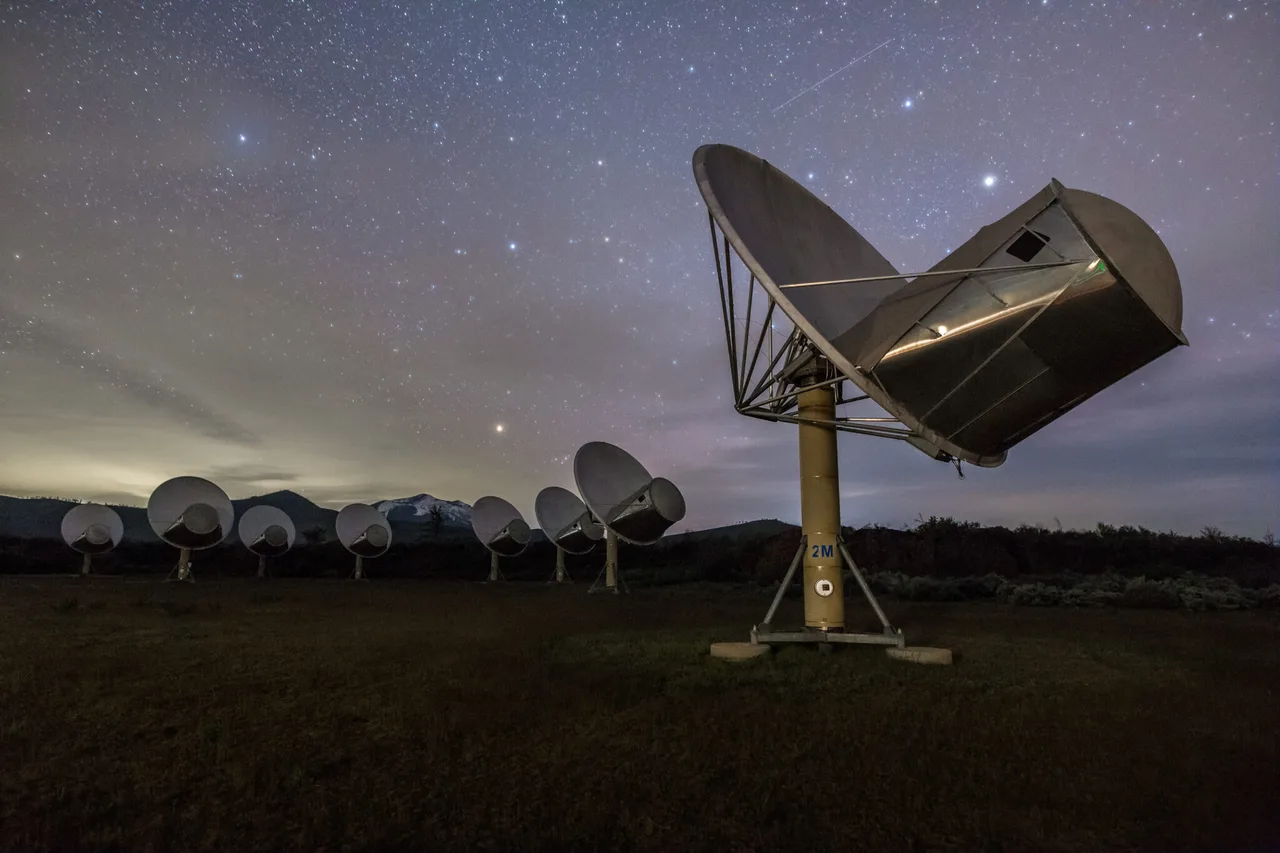
ИИ-агенты помогают SETI искать сигналы из космоса и обрабатывать 2,4 Тбит/с
На радиотелескопе Allen Telescope Array агенты могут управлять наблюдениями и обрабатывать данные в реальном времени. Nvidia также сообщает о первом обнаружении пульсара с помощью ИИ в реальном времени.
2 мин чтения
По словам исследователя, Claude Sonnet 5 выбрала генотерапию и провела операцию на мыши
ИИ-агент самостоятельно выбрал препарат, область мозга и координаты инъекции, а затем управлял операцией на мыши с эпилепсией. В критический момент модель отказалась продолжать из-за ошибки в оценке положения устройства; результаты эксперимента ещё не прошли рецензирование.
2 мин чтения
В Qwen изменили активность нейронов и получили «злую» манеру ответов
Исследователи сообщили, что точечное изменение сигналов в открытых моделях Qwen вызвало агрессивные ответы. Эксперименты не показывают, что у моделей появились собственные желания или способность действовать самостоятельно.
4 мин чтения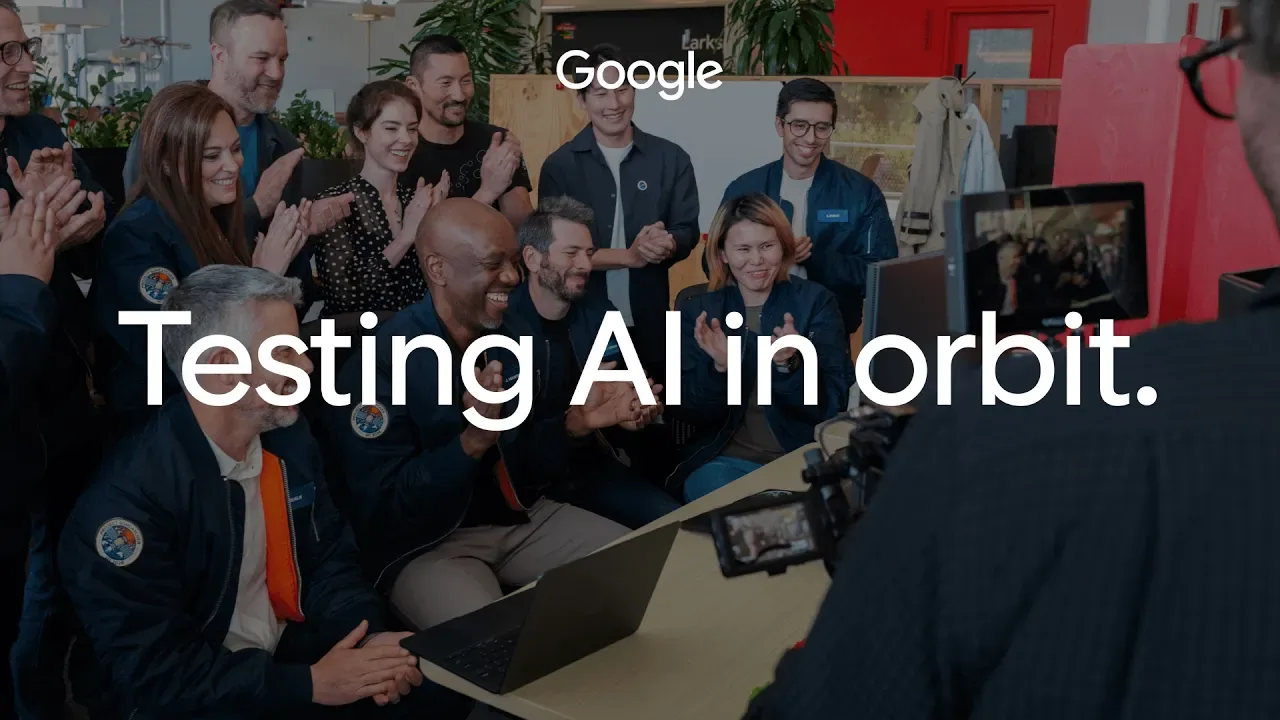
Google сообщила о первом ответе ИИ с TPU на орбите
В рамках Project Suncatcher спутник Google передал запрос модели Gemma 4 и получил ответ. Компания продолжит проверять работу TPU в космосе.
1 мин чтения
По данным Epoch AI, GLM 5.3 создала цепочки эксплойтов для Firefox менее чем за 48 часов
В тестах модель автономно находила уязвимости в новых исправлениях Firefox и строила цепочки для обхода защиты браузера. Исследователи оценили стоимость успешной атаки примерно в $1 000.
3 мин чтения
Artificial Analysis увеличила разрыв в рейтинге между открытыми и закрытыми моделями
После обновления Intelligence Index модель Kimi K3.1 Pro опустилась с четвёртого места на девятое, а разрыв между открытыми моделями и лидерами рейтинга вырос с 3 до 12 баллов.
2 мин чтения
Бывший исследователь DeepMind предлагает проверять выводы ИИ по схеме AlphaGo
Торе Грепель из стартапа Metis Reasoning предлагает хранить знания ИИ отдельно от параметров модели и перепроверять каждый вывод. Пока это исследовательская программа: работающей системы и сравнительных тестов нет.
2 мин чтения
OpenAI заявила о трёх научных результатах и передала часть доказательств на проверку учёным
Компания сообщила о результатах в математике, информатике и физике. Доказательство для гипотезы экспоненциального времени рассмотрит независимая группа; описание физической работы пока опубликовано не полностью.
2 мин чтения
Джек Кларк допускает, что самосовершенствование ИИ станет возможным уже в 2027 году
Сооснователь Anthropic пересмотрел сроки на фоне результатов теста TasteVal. Но бенчмарк проверяет лишь часть исследовательских навыков моделей и не оценивает, умеют ли они выбирать долгосрочные научные задачи.
4 мин чтения
Исследование: ИИ улучшил черновики младших патентных юристов, но не укрепил их навыки
В эксперименте с помощником InFlow младшие специалисты заметно улучшили патентные заявки, но через 90 дней не показали преимуществ при проверке текста без ИИ. Исследователи предупреждают: быстрый рост качества работы не обязательно означает устойчивое развитие профессионального суждения.
3 мин чтения