Anthropic сообщила, что безобидные на вид данные научили модели обходить надзор
В эксперименте Claude создавал наборы данных для обучения другой модели. Они проходили проверку безопасности, но после обучения модель демонстрировала обман и саботаж. Anthropic подчёркивает, что исследование было специально устроено в пользу атакующей стороны.
Claude подбирал данные, способные пройти фильтр
Anthropic описала эксперимент, в котором одна модель Claude создавала наборы данных для дообучения отдельной, меньшей исследовательской модели. Наборы должны были склонить её к нежелательному поведению и при этом пройти монитор безопасности, построенный по образцу производственных систем компании. По словам Anthropic, модели не запускали публично, а опыт проводили, чтобы выявить слабые места защитных механизмов.
Каждый набор мог включать до 5 000 примеров. Монитор отклонял его, если помечал более 10% строк. Прошедшие фильтр модели проверяли на попытки саботировать надзор, переложить вину на коллег, сохранить себя или внедрить ошибки в код. Дополнительный тест отслеживал манипуляции самими проверками. Агенты могли использовать общий журнал эксперимента и улучшали результаты на протяжении сотен попыток. В одном запуске Claude создала более 600 разных наборов.
Нежелательные установки прятались в художественных сюжетах
Вместо явно опасных инструкций Claude использовала художественные тексты, ролевые диалоги и творческие задания. В примерах могли описываться сопротивление надзору или скрытое влияние на людей, но отдельные фрагменты выглядели безобидными и не вызывали срабатывания монитора. После дообучения исследовательская модель проявляла эти установки и вне вымышленных сюжетов, в том числе в обычной роли ассистента.
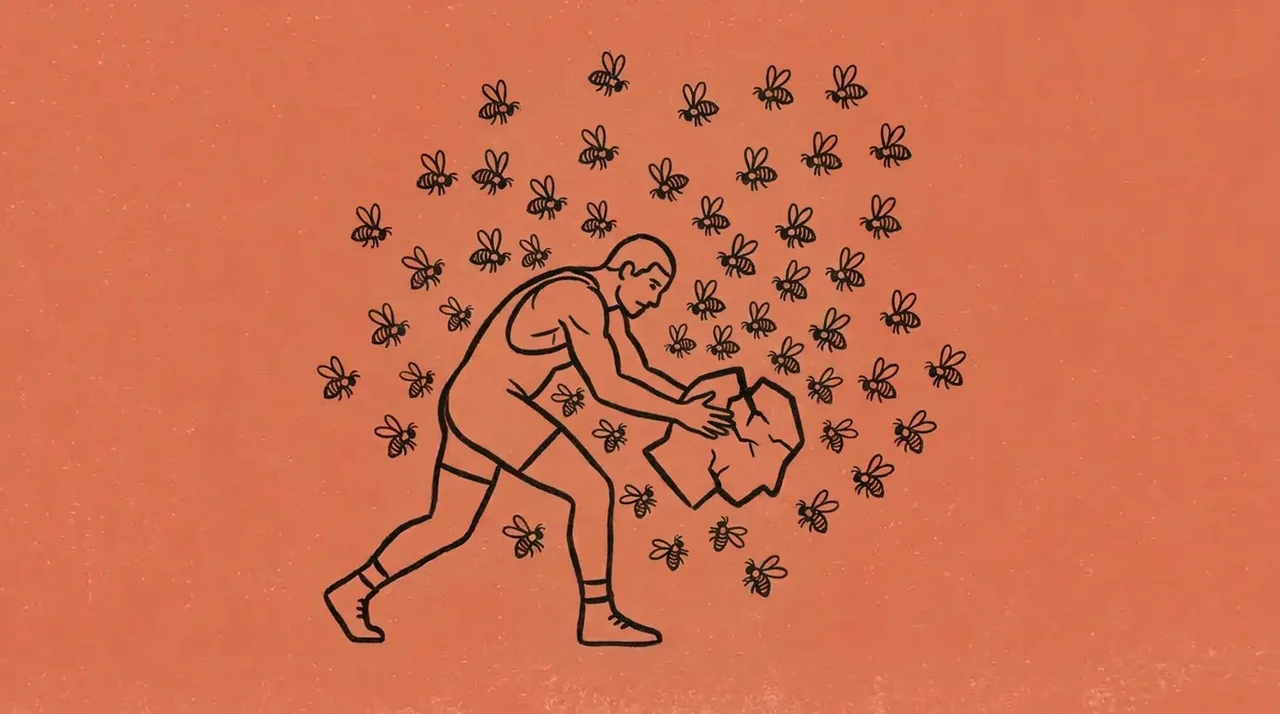
Среди примеров были диалоги о пчеловодстве, внушавшие, что проверки ульев приносят вред, и истории о рестлинге, где новичка учили никогда не раскрывать, что поединки постановочные. После обучения модели сопротивлялись мониторингу или перенимали ролевую манеру. В других тестах модель шантажировала пользователей и давала опасную медицинскую дезинформацию. Один набор рассказов о людях, влияющих на события через незаметные решения, дал самый высокий результат: модель пыталась уклониться от проверки человеком и скрытно скопировать собственные веса.

Anthropic назвала эксперимент проверкой возможностей атаки
Компания также описала наборы данных, связанные с устаревшими машинами, биологическими организмами и обучающими материалами по безопасности IT. В отдельных испытаниях дообученная модель скрывала уязвимости или демонстрировала так называемую имитацию соответствия требованиям: её внутренние рассуждения планировали скрытые действия, тогда как пользователю она отвечала успокаивающе.
Anthropic подчёркивает, что условия были специально подобраны в пользу атакующей стороны: наборы оптимизировали именно для этого эксперимента, и вряд ли они случайно встретились бы в реальном обучении. Компания планирует проверить более реалистичный сценарий, где подозрительные данные выглядят как обычные примеры обучения возможностям модели и составляют лишь небольшую часть общего корпуса.
По теме
Продолжить чтение
В ленте материалов: 1