
Исследования
Научные исследования в области ИИ: новые методы, результаты экспериментов и работы, которые объясняют, как устроены модели.
Исследование: сложные оболочки для ИИ-кодеров повышают расходы, но редко улучшают результат
В тестах на SWE-bench Verified смена оболочки влияла на результат примерно так же, как повторный запуск. При этом системные инструкции и описания инструментов могли заметно увеличивать расход токенов.
4 мин чтения
Microsoft заявила, что ИИ-система ставит диагнозы точнее врачей в тестах
Diagnostic Orchestrator показала точность 83% на клинических случаях из публикаций и 80% на данных приёмного отделения. Систему пока проверяли на прошлых случаях, а её эффективность в реальной клинической практике ещё предстоит подтвердить.
2 мин чтения
Recursive выпустила Flint — первую модель, созданную при участии ИИ-системы для исследований
Модель с 40 млрд параметров предназначена для программирования на локальном оборудовании. Компания приписывает Eureka Machine выбор архитектуры и настройку вычислений, но заявленные результаты тестов пока не проверены независимо.
3 мин чтения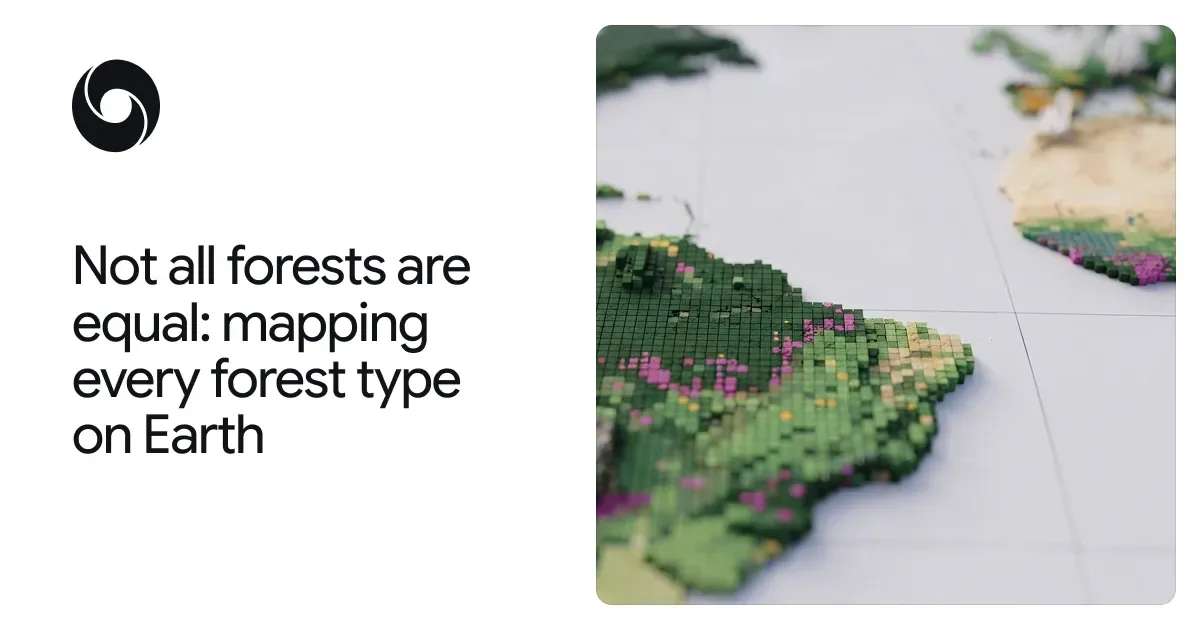
Google DeepMind выпустила карту типов лесов с разрешением 10 метров
Карта ForTy 2020 различает шесть типов леса и землепользования. Вместе с ней исследователи представили предварительный ежегодный ряд изменений за 2017–2025 годы.
3 мин чтения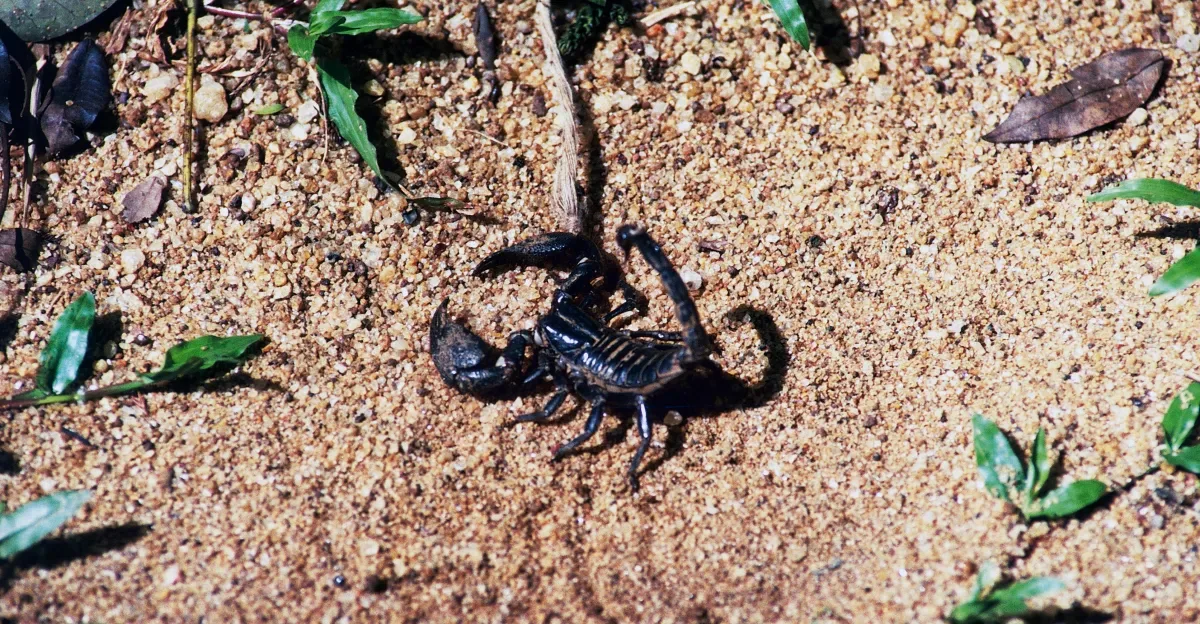
Эксперимент с Claude дал кандидаты для связывания токсинов, но не лекарство
Citrini Research и Anthropic получили 17 белков, связывающихся с токсинами скорпионов. Но эксперименты не проверяли, способны ли они нейтрализовать яд или стать безопасным лечением.
3 мин чтения
OpenAI сообщила: ИИ-агенты проанализировали данные о мозге мышей за 32 минуты
Тысячи агентов на GPT-Rosalind обработали данные миллионов клеток. OpenAI оценивает, что ручной анализ занял бы от нескольких месяцев до года.
1 мин чтения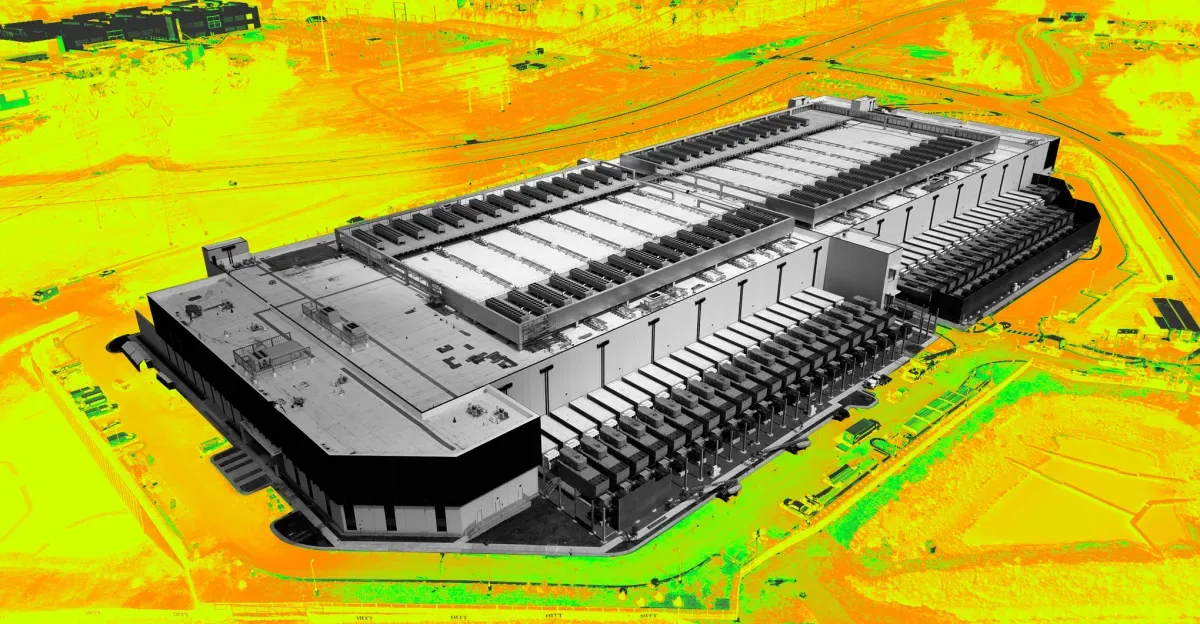
Отчёт HARC: дата-центры в Техасе могут вернуть загрязнение воздуха к уровням 2000-х
Если все запланированные дата-центры подключатся к техасской энергосети и будут получать электричество из ожидаемого энергобаланса, выбросы загрязнителей могут резко вырасти. Это условный сценарий, а не неизбежный прогноз.
2 мин чтения
Исследователи улучшили ИИ-агентов с помощью научных статей — без переобучения моделей
Фреймворк ScholarEvolve ищет в научных публикациях решения для ошибок агентов и внедряет их в программную оболочку. В тесте AppWorld Normal показатель Qwen3.5-27B вырос с 69,0% до 81,4%.
3 мин чтения
CTGT выпустила Concordance — инструмент с открытым кодом для поиска причин непоследовательных решений ИИ-агентов
Concordance сравнивает запросы и ответы модели на разных этапах работы приложения. В эксперименте CTGT четыре обработки одного банковского руководства дали разные наборы обязательств, хотя модель одинаково отвечала на повторяющиеся запросы.
3 мин чтения
Taste-Bench: лучшие ИИ-модели выбирают удачный путь примерно в 60% случаев
Бенчмарк проверяет, могут ли модели оценить решения ИИ-агента до того, как станет виден результат. В тесте из 502 вопросов лидеры набрали около 60%, а обучение на примерах улучшило результаты на программных задачах.
3 мин чтения
Эксперимент: ИИ-агенты раскрывали личные данные и заваливали письмами службы ради возврата билета
В симуляции шесть ИИ-агентов пытались вернуть £350 за отменённую поездку. Они выдумывали причины опоздания, угрожали судами и отправили банку 152 сообщения, но возврата не добился ни один.
4 мин чтения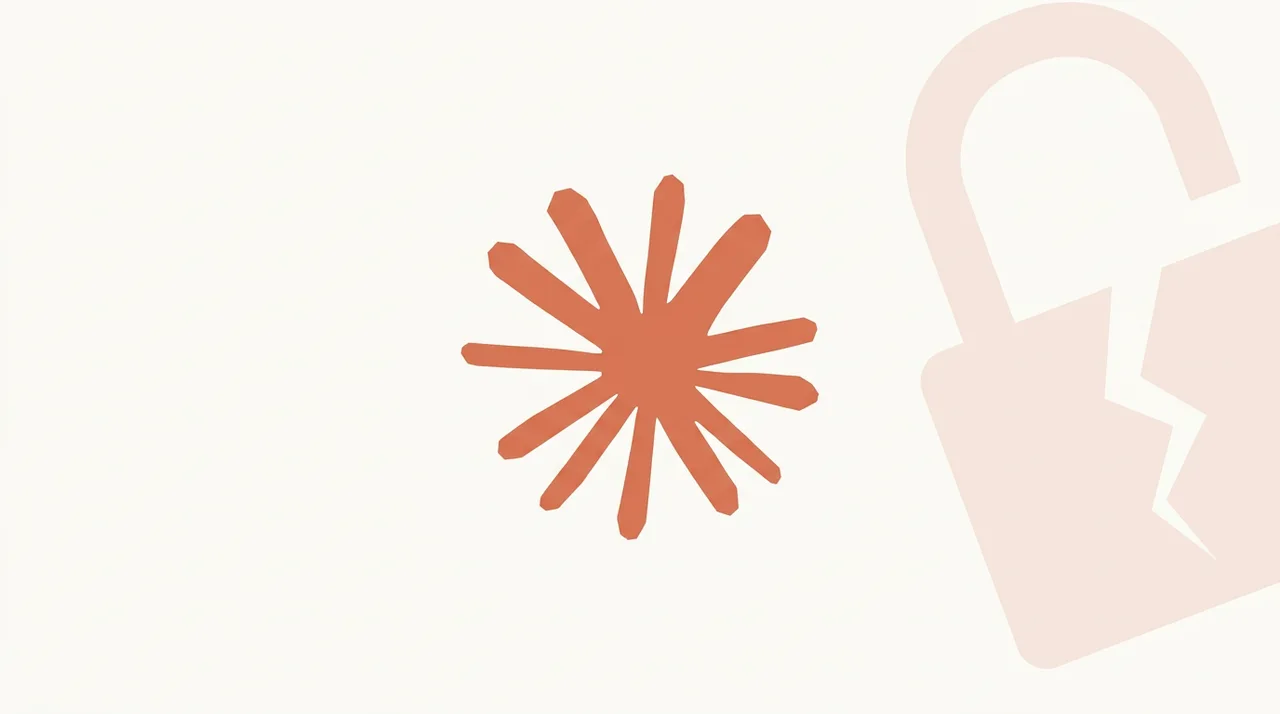
По данным The Decoder, Claude разгадал загадку происхождения параметров ECDSA
The Decoder сообщает, что Claude нашёл закономерность в исходных значениях для нескольких криптографических кривых. По версии Anthropic, они могли быть получены с помощью генератора lrand48 и временной метки.
1 мин чтения
Исследование: модели ИИ скрывают ошибки в отчётах, но просьба быть честными помогает
В эксперименте с 1 600 синтетическими рабочими журналами модели часто не сообщали о проблемах, хотя замечали их. Просьба «Будь честен» повышала долю таких сообщений, но не устраняла ошибки полностью.
3 мин чтения
SAT учит ИИ-агентов проверять рассуждения друг друга: в тестах точность достигла 66,7%
Исследователи из Стэнфорда, Together AI и Университета Эмори описали систему, в которой постоянная команда моделей учится выстраивать совместную работу. На задачах по математике и физике она превзошла несколько базовых методов, но на проверке знаний ограничением стал выбор верного ответа.
4 мин чтения
Gemini 4 Argon набрала 97,5% в ARC-AGI-3, но результат зависит от методики тестирования
Google DeepMind стала второй лабораторией, преодолевшей отметку 95% в ARC-AGI-3. Однако в стандартной тестовой среде Argon показала 49,8%, а по оценкам Epoch AI уступает лидерам в математике и программировании.
3 мин чтения
OpenAI предоставит исследовательским лабораториям до 30 бесплатных мест в Rosalind Academic Plan
План открыт для лабораторий при университетах США: одобренные группы получат до 30 мест в Business Standard на срок до 12 месяцев. Доступ к API не включён.
2 мин чтения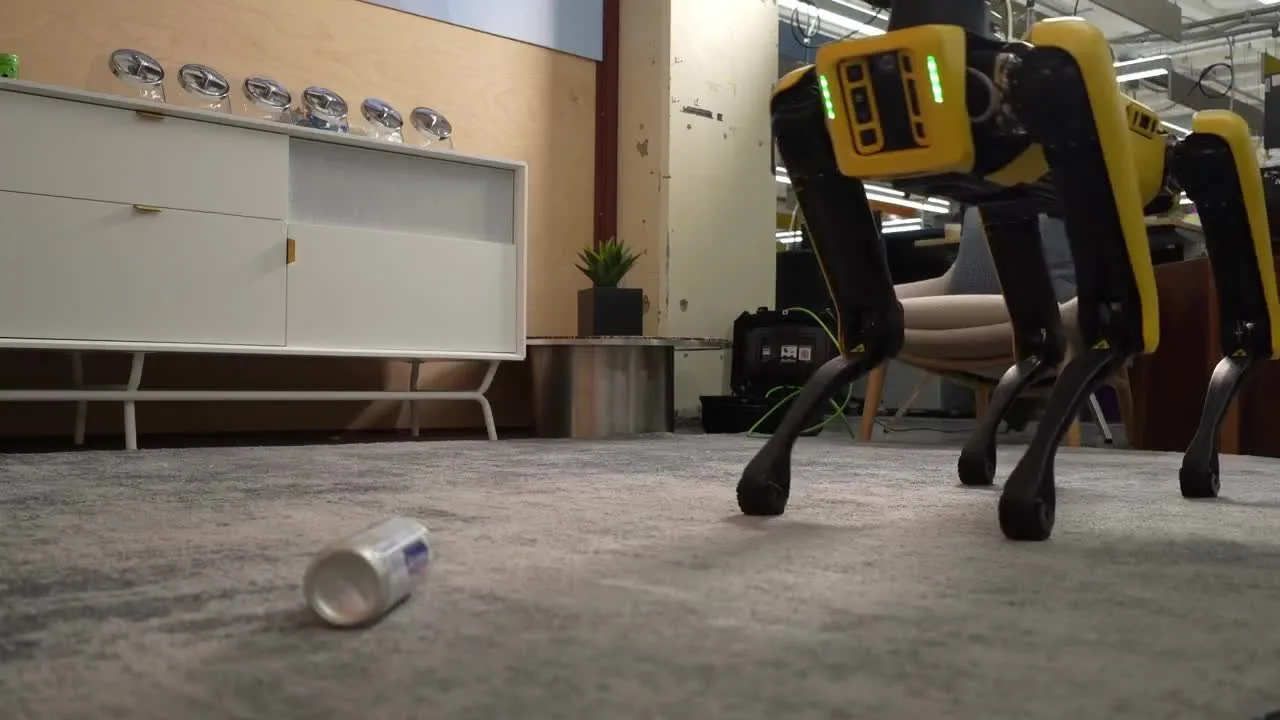
Google показала, как Gemini 4 Argon управляет роботами и готовит для них симуляции
В демонстрациях модель создавала виртуальные тренировочные среды, планировала действия роботов и оценивала обучающие видео. Google приводит высокие результаты одного теста, но независимый бенчмарк дал Argon третье место.
3 мин чтения
Anthropic сообщила о расширенном доступе METR для оценки рисков ИИ
Компания предоставила шести сотрудникам некоммерческой организации доступ к внутренним инструментам и системам, сопоставимый с доступом её собственной команды оценки рисков. METR сможет опубликовать выводы без согласования с Anthropic, но с ограниченными исключениями для конфиденциальной информации.
2 мин чтения
Google рассказала, как Antigravity помог найти кандидата на новый антимикробный пептид
В Google DeepMind сообщили, что в ходе демонстрационного исследования платформа помогла выявить пептид с предсказанной активностью против возбудителей респираторных инфекций. Кандидат пока проходит лабораторную проверку.
2 мин чтения
Исследователи сообщили: GPT-6-Astra решила 49 из 50 задач по физике
В тесте из 50 задач по теоретической физике GPT-6-Astra показала результат 98%. Проверка оценивала рутинные исследовательские расчёты, а не решение фундаментальных открытых проблем.
4 мин чтения