Бывший исследователь DeepMind предлагает проверять выводы ИИ по схеме AlphaGo
Торе Грепель из стартапа Metis Reasoning предлагает хранить знания ИИ отдельно от параметров модели и перепроверять каждый вывод. Пока это исследовательская программа: работающей системы и сравнительных тестов нет.
Знания — отдельно, выводы — с проверкой
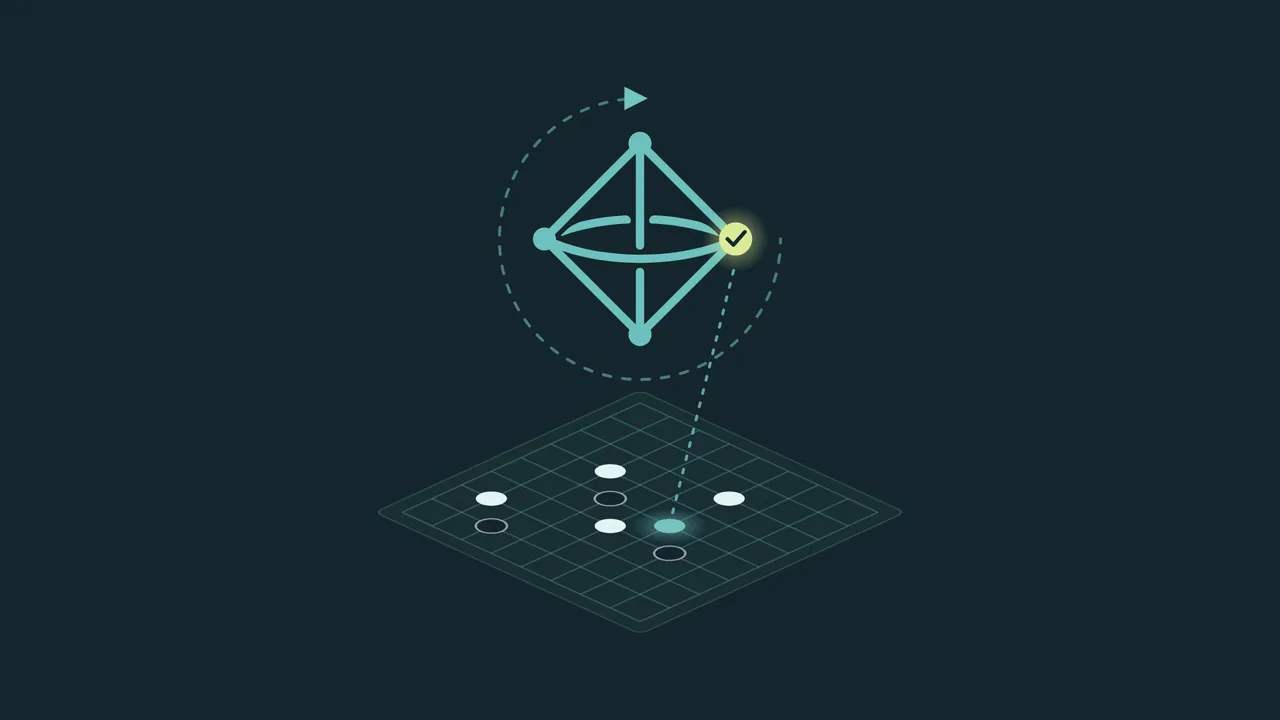
Торе Грепель, бывший исследователь DeepMind и основатель Metis Reasoning, представил на конференции Nvidia GTC в Берлине подход к проверяемому рассуждению ИИ. По замыслу команды, он переносит на общие задачи принцип AlphaGo: нейросети предлагают и оценивают следующие шаги, а поиск проверяет варианты.
Вместо игрового поля система использует явный реестр знаний. В нём отмечаются известные сведения, уверенность в них и нерешённые вопросы. Отдельный модуль проверяет новые записи с помощью вычислений, формальных доказательств или эмпирических данных. Если предположение опровергнуто, система пересматривает выводы, которые на нём основывались.
Следующим шагом может стать вопрос, эксперимент или проверка уже принятого допущения — система выбирает вариант, который, по её оценке, сильнее всего уменьшит неопределённость. Итогом должен быть ответ либо обоснованный отказ от ответа. По словам Metis, такой подход также позволит менять или удалять отдельные знания без переобучения модели.
Метод пока не проверяли на работающей системе
Metis утверждает, что увеличение объёма данных и вычислений не устраняет фундаментальные проблемы языковых моделей: те могут выдавать вымышленные ответы, а их знания хранятся в параметрах. Компания рассчитывает, что проверка каждого шага позволит сократить такие ошибки и сделать основания для ответов прослеживаемыми.
Авторы также признают, что реальные задачи отличаются от игры в го: информация может быть неполной, получение доказательств — дорогим, а некоторые вопросы не имеют ответа. Открытым остаётся и вопрос, как формировать реестр знаний в сложных областях, не превращая его в систему, где сведения приходится вводить вручную.
Продолжить чтение
В ленте материалов: 1