Fable 5.2 выполнила 41,3% реальных фриланс-задач в тесте Scale Labs
В бенчмарке Remote Labor Index модель показала результат более чем вдвое выше, чем её предшественница Fable 5.1. Тест охватывает полноценные проекты с Upwork, а не отдельные навыки.
Результат Fable 5.2 в бенчмарке
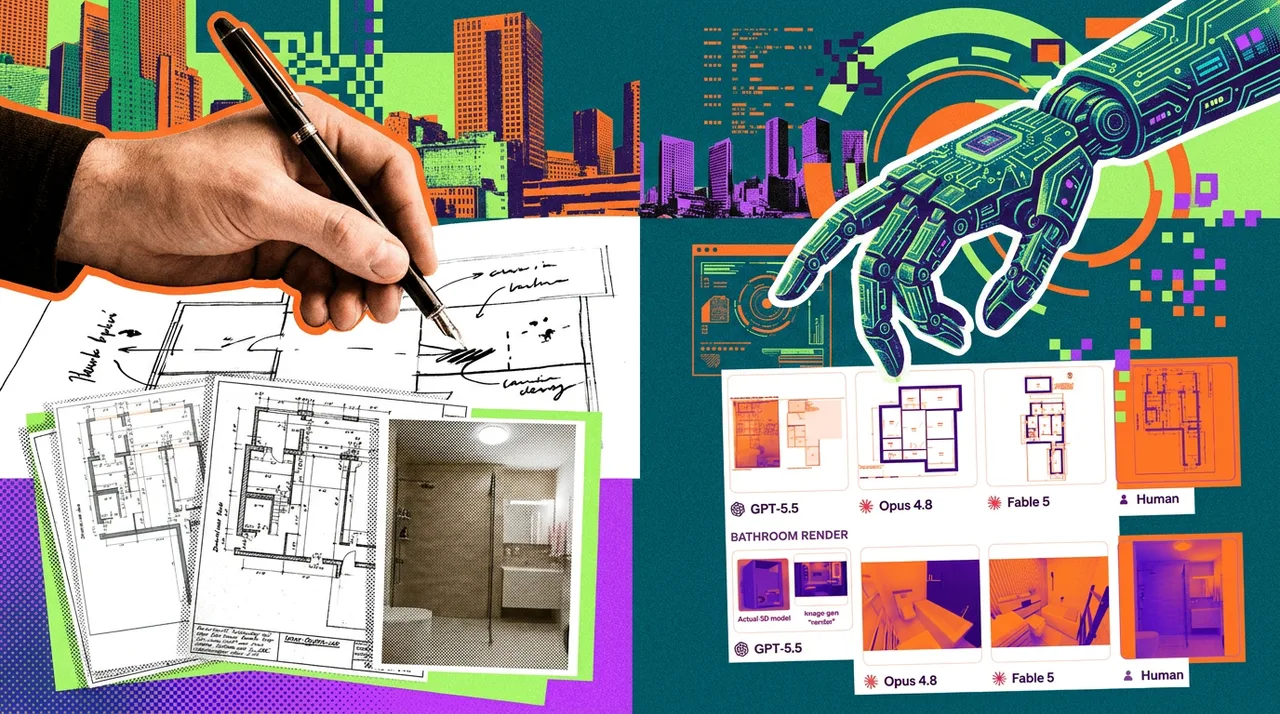
В тесте Remote Labor Index от Scale Labs модель Fable 5.2 выполнила 41,3% профессиональных заданий. Для сравнения, предыдущая модель Fable 5.1 справилась с чуть менее чем 18%, а Fable 5 в июльском замере набрала около 16%.
Когда бенчмарк запустили примерно год назад, лучший результат составлял 2,5% — столько заданий выполнила модель Manus. Таким образом, показатель Fable 5.2 более чем в 16 раз выше. В текущем рейтинге следом за ней идут Opus 5.5 с 21,25% и GPT 6 Astra с 20,83%. Gemini Argon 4 заняла пятое место с 17,08%; более ранние GPT-5.2 и Gemini 3 Pro набрали менее 3%.
Сильные стороны и ошибки агента
По словам Scale Labs, наиболее заметный прогресс Fable 5.2 показала в редактировании аудио и музыки, проектировании архитектуры и интерьеров, а также создании 3D-моделей. Агент справляется и с длительными сложными проектами, которые регулярно оказывались не по силам лидерам предыдущих тестов. Почти 50 успешно выполненных заданий модель решила впервые среди ИИ-агентов, участвовавших в бенчмарке.
При этом Scale Labs отмечает, что агент пока с трудом справляется, в частности, с промышленным дизайном и анимацией. По описанию исследователей, неудачные ответы часто выглядят непрофессионально, остаются незавершёнными, содержат повреждённые файлы или противоречивые решения.
Как устроен Remote Labor Index
Вместо проверки отдельных навыков Remote Labor Index оценивает выполнение целых рабочих заданий. В набор вошли 240 завершённых проектов 358 проверенных специалистов с Upwork; общая стоимость работ составляет около $144 000. Один проект в среднем стоит $632,60 и занимает у фрилансера чуть менее 29 часов. Задания охватывают, например, монтаж видео, проектирование в CAD, разработку игр и анализ данных.
Агенты получают виртуальное рабочее пространство с профессиональными программами, включая Blender, GIMP и Audacity, и специализированными инструментами для генерации изображений, аудио и видео. Результаты проверяют обученные эксперты: они открывают файлы в соответствующих программах и сравнивают работу агента с результатом фрилансера. Попытки автоматизировать проверку с помощью другого ИИ пока не удались: по данным исследователей, такие проверяющие недостаточно хорошо работают с профессиональным ПО и могут переоценивать внешне качественные, но технически ошибочные результаты.
По теме
Продолжить чтение
В ленте материалов: 1