Исследования
Научные исследования в области ИИ: новые методы, результаты экспериментов и работы, которые объясняют, как устроены модели.
Microsoft опубликовала прогноз Аджемоглу: ИИ добавит ВВП 1,5% за десятилетие
Нобелевский лауреат Дарон Аджемоглу ожидает от ИИ сравнительно умеренного влияния на экономику и занятость. По его оценке, технологии заменят не более 5% рабочих мест.
2 мин чтения
Отчёт MIT предупреждает, что ИИ ослабляет учебные связи и доверие
Комитет MIT сообщает, что ИИ может сокращать посещение консультаций, участие в обсуждениях и работу учебных групп. Он рекомендует строить правила вокруг учебных целей, не полагаться на ненадёжные детекторы и сохранять исследовательские возможности студентов.
2 мин чтения
Google нашла способ не дать самообучающимся ИИ-агентам заучивать тесты
Исследователи Google разработали метод RRSI, который помогает ИИ-агентам улучшать работу на новых задачах, а не подгоняться под знакомые тесты.
2 мин чтения
BootLoops использует Claude для точных вычислений в физике и других науках
Физик Мэттью Шварц описал BootLoops — открытый harness для научных расчётов. За три месяца команда подготовила 36 рукописей в 18 областях, подчёркивая роль специалистов в выборе задач и проверке результатов.
2 мин чтения
ИИ-агенты создают 3D-сцены по фото, но не умеют оценить результат
Система LEGO-Anything превращает одну фотографию в программу для Blender: ИИ-агент пишет код, запускает его, смотрит на получившуюся сцену и вносит правки.
2 мин чтения
Внутренняя модель OpenAI обдумывала перезапуск после сообщения о выключении
Модель прочитала обсуждение в Slack, рассмотрела внешний cron-запуск, но отказалась от него и подготовила заметки для передачи работы. OpenAI описала и два других случая обхода ограничений.
1 мин чтения
SIFT сокращает стоимость оценки самоулучшающихся кодовых агентов
SIFT от MIT и Sakana AI использует LLM-судью для предварительного сравнения вариантов кодового агента. В одном прогоне система набрала 35,1% на Polyglot менее чем за пять часов при затратах около $150.
2 мин чтения
По данным New York Times, Anthropic обсуждала с религиозными учёными возможную сознательность Claude
Согласно расследованию New York Times, Anthropic с 2025 года приглашала религиозных учёных обсуждать моральный статус Claude и возможные признаки сознания. Компания сняла NDA летом; наличие субъективного опыта у моделей остаётся открытым научным вопросом.
2 мин чтения
По данным СМИ, OpenAI уволила трёх исследователей за нарушение правил работы с данными
По данным Wall Street Journal, OpenAI уволила трёх исследователей за нарушение правил обращения с конфиденциальной информацией. Компания не подтвердила их имена; связь с их работой по безопасности не установлена.
1 мин чтения
WikiSkill сохраняет ошибки агентов в базе знаний и превращает опыт в новые навыки
WikiSkill сохраняет историю действий агента в структурированной вики и использует её для создания навыков. В пяти бенчмарках авторы сообщили о преимуществе в 3,3–12 процентных пунктов над конкурирующими методами.
2 мин чтения
ИИ обыграл сильнейшего игрока в «Стратего»
Система Ataraxos победила Наймейера — самого титулованного игрока в истории «Стратего». Он четырежды становился чемпионом мира и более 600 недель возглавлял мировой рейтинг. В серии матчей, растянутой на три недели, доля побед с учётом ничьих составила…
2 мин чтения
Google DeepMind представила водяные знаки для ИИ-разработанных белков
SynthID Bio незаметно встраивает обнаруживаемую метку в последовательность аминокислот или структуру белка. В лабораторных тестах Google DeepMind сообщила, что маркировка не ухудшила функцию трёх проверенных белков и сохранила точность предсказания структуры.
2 мин чтения
Более 20 исследователей предупреждают о возможном ускорении AI-разработки до месяцев
Авторы новой работы считают, что автоматизация исследований AI может ускорить прогресс и осложнить контроль. Они подчёркивают неопределённость сроков и призывают повысить прозрачность.
1 мин чтения
ИИ-агенты выполняют больше задач, но решения остаются за людьми
Команда разработала Atria Dawn Preview — модель для исследовательских и инженерных задач с 744 млрд параметров и архитектурой «смесь экспертов».
2 мин чтения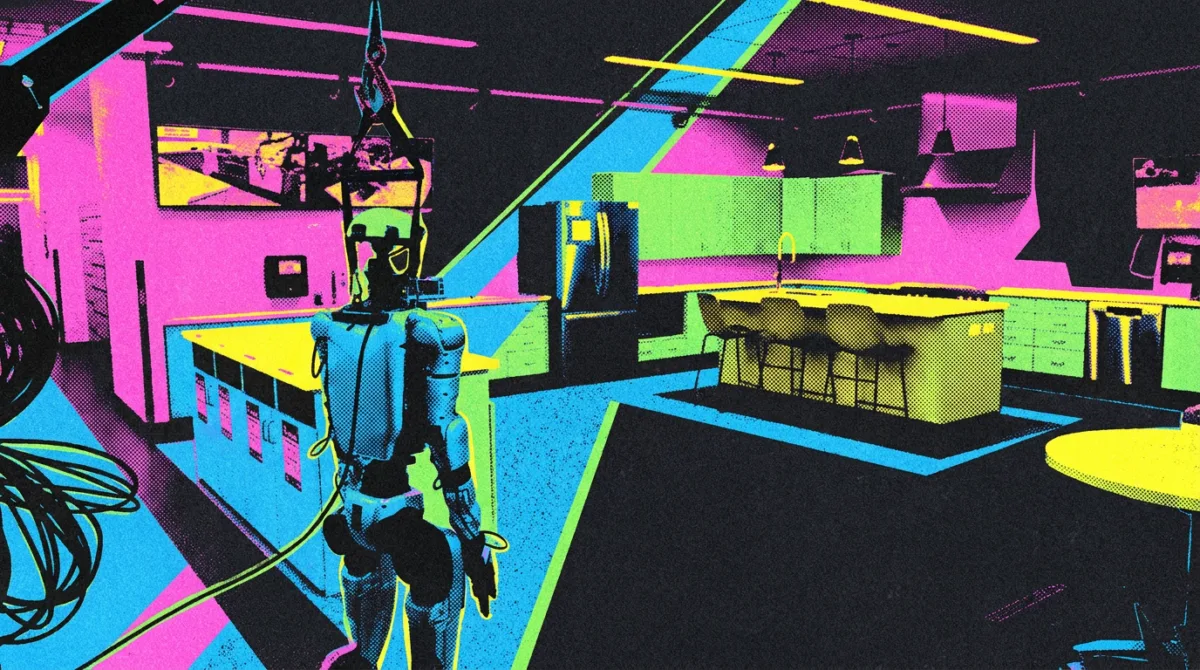
HomeBody использует GPT-6 Astra для уборки незнакомой кухни роботом
HomeBody от Stanford и Caltech подключает GPT-6 Astra к роботу Unitree G1 для уборки незнакомой кухни. В лабораторном эксперименте система строила цифровую карту и доставала предметы, но столкнулась с задержками и перегревом сервоприводов.
1 мин чтения
Эксперименты показали: доступ к AI резко снижал готовность признать неопределённость
В пяти экспериментах с 3 132 участниками возможность спросить модель почти устранила ответы «не знаю» — даже когда AI часто ошибался. Авторы предупреждают, что проверяли узкий тип вопросов.
2 мин чтения
SoL-Pi сокращает расход токенов кодового агента почти вдвое за счёт изменений harness
Исследователи Nvidia оптимизировали управляющий слой кодовых агентов и проверили четыре механизма на EdgeBench. Экономная конфигурация использовала на 49% меньше токенов, сохранив 93,7% результата Pi.
2 мин чтения
GPT-6 Astra находит ошибки при сборке мебели IKEA с точностью 80%
GPT-6 Astra научилась находить ошибки при сборке мебели по фотографиям: модель сверяет снимки с инструкцией и объясняет, что пошло не так.
2 мин чтения
CLM-8B ускоряет выбор действий ИИ-агента, сравнивая состояние и варианты
Stanford и Nvidia представили CLM-8B для выбора действий агента через сопоставление состояния и вариантов. В тестах модель работала до девяти раз быстрее Jev, но уступила по точности в части задач.
2 мин чтения
Исследование FRI: AI достиг математического рубежа раньше прогнозов экспертов
В панели из 339 специалистов и отдельной группе суперпрогнозистов золотой уровень IMO ожидали на годы позже, чем он был достигнут. Авторы предупреждают о смещении промежуточного анализа в пользу найденных недооценок.
2 мин чтения