Исследователи улучшили ИИ-агентов с помощью научных статей — без переобучения моделей
Фреймворк ScholarEvolve ищет в научных публикациях решения для ошибок агентов и внедряет их в программную оболочку. В тесте AppWorld Normal показатель Qwen3.5-27B вырос с 69,0% до 81,4%.
Научные публикации — источник улучшений для агентов
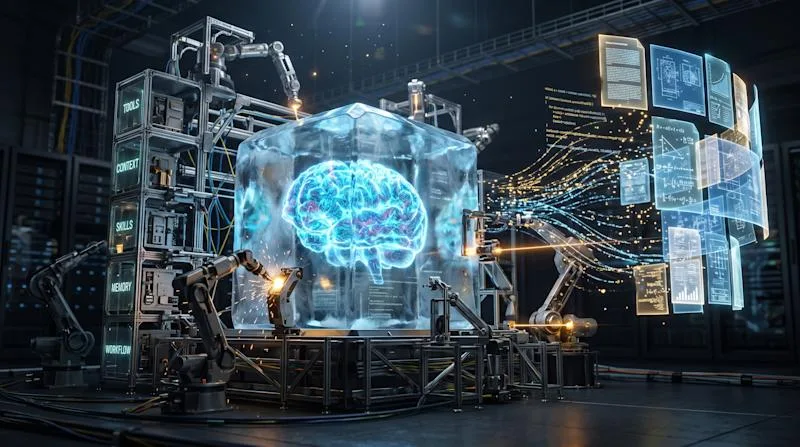
Исследователи из Калифорнийского университета в Санта-Барбаре и Microsoft представили ScholarEvolve — фреймворк, который ищет в научных статьях методы решения проблем ИИ-агента и превращает их в изменения его программной оболочки. В описанном авторами подходе веса базовой модели остаются неизменными. Работа опубликована на arXiv.
Большинство прежних систем оптимизации оболочек опираются на ошибки и успешные действия, которые агент уже совершал. Авторы считают, что такой замкнутый цикл ограничен знаниями исходной модели и не всегда подсказывает, как устранить незнакомую проблему. ScholarEvolve добавляет к анализу опыта поиск внешних исследовательских решений. О том, как устроен цикл работы ИИ-агентов, можно прочитать в объяснении разницы между агентом и чат-ботом.
Как фреймворк меняет программную оболочку
Сначала система анализирует неудачные задачи на обучающем наборе, выделяет общие пробелы и ищет подходящие статьи на arXiv. Затем группирует публикации по типам предлагаемых решений, чтобы изучать разные подходы, а не похожие работы.
Исследовательский агент изучает выбранную статью и доступный официальный код, после чего составляет план изменений. Кодировщик реализует его на Python в одном из пяти модулей: интерфейсе инструментов, управлении контекстом, навыках, памяти или рабочих процессах агента. Остальные модули при этом не меняются.
Перед полной оценкой автоматические проверки выясняют, импортируется ли код, соблюдает ли он интерфейсные требования и формирует ли допустимые действия. Затем система объединяет удачные изменения разных модулей и проверяет получившуюся оболочку на регрессию. По описанию авторов, новое решение заменяет прежнее только после статистической проверки улучшения.
Результаты на AppWorld и Telecom
В тесте AppWorld Normal оболочка ScholarEvolve подняла долю выполненных задач модели Qwen3.5-27B с 69,0% до 81,4%. Авторы указывают, что это сократило примерно 74% разрыва в результатах с GPT-5.4, при этом веса Qwen не обновлялись.
На AppWorld показатель выполнения сценариев, где нужно успешно пройти три варианта одной задачи, вырос на 20,2 процентного пункта. В отдельном тесте AppWorld Challenge, включавшем незнакомые агенту приложения и API Amazon и Gmail, результат Qwen3.5-27B увеличился с 49,6% до 63,6%. На тесте Telecom оболочка также улучшила результат GPT-5.4-mini: с 72,7% до 81,9%. Это результаты экспериментов исследователей, а не подтверждение эффективности системы в производственной среде.
Среди описанных изменений — проверка вызовов Python перед исполнением, вывод документации API по запросу, сокращение истории диалога с учётом её важности и повторное использование типовых последовательностей API. Авторы также обнаружили, что результат отдельного модуля не всегда предсказывает, насколько хорошо он сработает в сочетании с другими.
Ограничения внедрения
На момент публикации статьи репозиторий ScholarEvolve на GitHub был пуст. В приложениях к исследованию приведены фрагменты кода выбранных модулей. Авторы провели три последовательных раунда обновления литературы и сообщили об улучшении результатов на AppWorld Normal, но не проверяли непрерывную адаптацию в реальном производственном окружении.
Описанные автоматические проверки оценивают работоспособность и совместимость кода, но статья не описывает проверку найденных публикаций и сторонних библиотек на вредоносные зависимости, небезопасное исполнение или уязвимости к внедрению инструкций. Исследователи рекомендуют не допускать непроверенные изменения в производственные системы и использовать проверку безопасности либо курируемый внутренний набор материалов. Эволюция оболочки также не заменяет защитные правила на уровне API и не исправляет слабый поиск данных.
По теме
Продолжить чтение
В ленте материалов: 1