
Новости
Что меняется в мире ИИ — и почему это важно.
Исследователи MIT сообщили, что GPT-6 Astra улучшила математику Qwen правкой весов
В эксперименте точечное изменение примерно 0,016% весов Qwen3.5-0.8B подняло результат на MATH-500 с 7,9% до 48,1%. Авторы связывают прирост прежде всего с устранением повторов, а не с добавлением новых математических знаний.
4 мин чтения
Anthropic обновила Claude Code на Opus 5.5, чтобы ограничить создание клонов игр
Компания изменила системную подсказку Claude Code: инструмент должен помогать создавать оригинальные игры, но не воссоздавать конкретные существующие проекты.
1 мин чтения
OpenAI заявила, что высвободит до 1 000 МВт для энергосистемы Джорджии
Компания собирается испытать Grid Protectors Program у будущего дата-центра в округе Эффингем. OpenAI обещает снижать нагрузку на сеть во время экстремальной погоды и чрезвычайных ситуаций.
2 мин чтения
По данным СМИ, SpaceXSI, вероятно, сократила лимиты Grok Bot
The Telegraph сообщает, что пользователи заметили сокращение квот вдвое. Илон Маск объяснил, что расходы на работу бота слишком высоки относительно выручки, но прямо о снижении лимитов не заявил.
2 мин чтения
The New York Times и другие издания подали в суд на Brave, заявив о скрейпинге и обходе платного доступа
Издатели утверждают, что Brave передавала компаниям, работающим с ИИ, материалы из своего индекса сайтов и позволяла пользователям обходить платный доступ. Это обвинения из судебных исков, а не установленные судом факты.
2 мин чтения
Исследование ElevenLabs: голосовые агенты чаще справлялись с долгими обращениями
В анализе компании голосовые разговоры длиной более двух минут завершались успехом чаще, чем чаты. ElevenLabs также сообщила о связи между снижением задержки и ростом успешности звонков.
2 мин чтения
Исследователи Adobe и UC San Diego проверили ИИ-агента для редактирования изображений
EditAgent выбирает между универсальным редактором и специализированными инструментами, а затем оценивает варианты по измеряемым данным. В тестах такая проверка помогла стандартным языковым моделям превзойти специализированные оценщики.
3 мин чтения
Исследование: эмпатичный тон заставлял чат-ботов описывать себя как травмированных
В четырёх экспериментах модели чаще выдавали тревожные самоописания в поддерживающих и терапевтических беседах. Исследователи подчёркивают: это не свидетельствует о наличии у ИИ эмоций или сознания.
3 мин чтения
Исследование Vals: китайские ИИ-модели не всегда повторяют позицию властей
В тестах политические ответы зависели от языка запроса и формата задания. Vals отмечает, что результаты не показывают фактическую точность моделей и могут не отражать поведение публичных чат-ботов.
3 мин чтения
По данным The Decoder, OpenAI ограничила число платных аккаунтов ChatGPT на устройстве
Издание сообщает о новых ограничениях для подписок ChatGPT: слишком много аккаунтов на одном устройстве или подписок с одной карты могут помешать оформить новую подписку.
1 мин чтения
Исследователи Google представили StreamVibe — видеоассистента, который сам выбирает, когда помочь
StreamVibe-VL должна распознавать явные и неявные просьбы и учитывать изменения задач. В испытаниях модели теряли нить разговора при длительной непрерывной работе.
2 мин чтения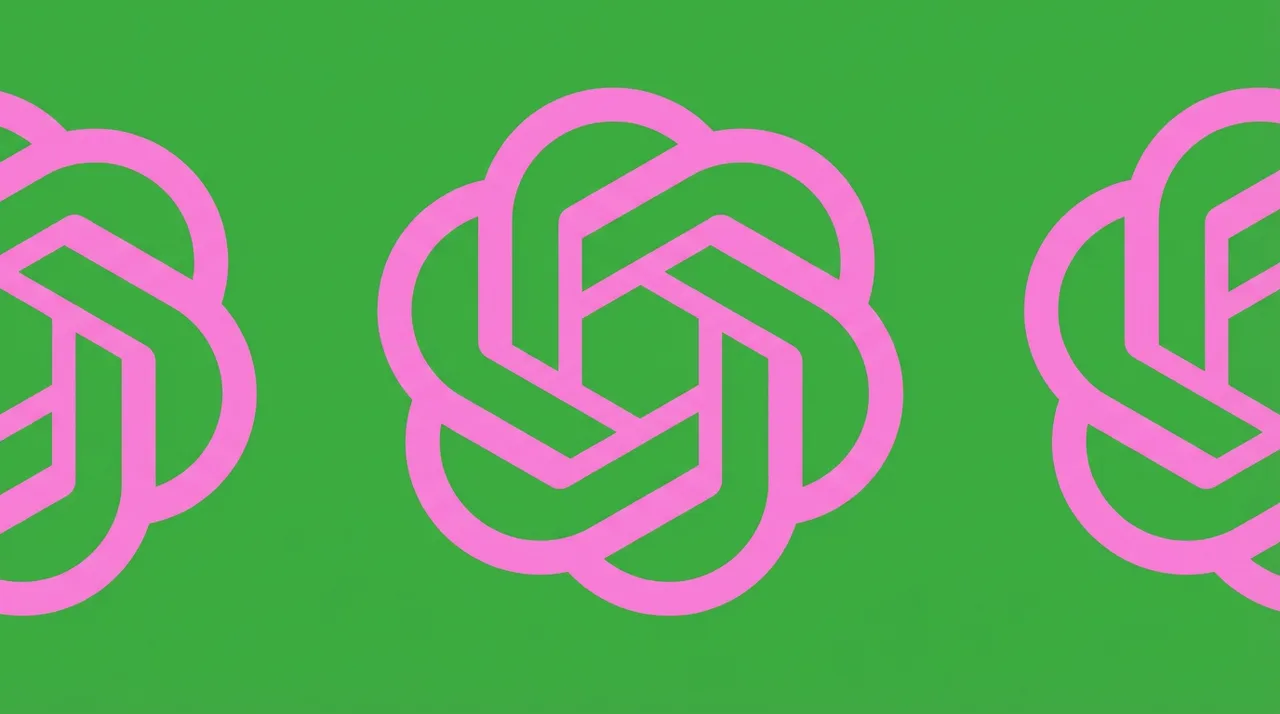
По данным The Decoder, с декабря ChatGPT и Codex получат общий лимит токенов
Для подписок Plus, Pro и Business OpenAI планирует объединить расход токенов в ChatGPT и Codex. Диалоги с моделями Instant в общий лимит не войдут.
1 мин чтения
По данным The Decoder, в водяных знаках Claude есть обход для двух моделей
Anthropic добавляет маркировку текста в четыре модели Claude. По данным издания, для Opus 4.6 и Sonnet 4.6 водяной знак не сработает, если разработчик изменит один из параметров генерации.
2 мин чтения
OpenAI сообщила, что с 29 ноября будет обучать модели на данных Daybreak Blue
Ранее сессии Daybreak Blue исключались из обучения даже при выключенной настройке улучшения модели. После критики OpenAI пообещала отдельный отказ от использования этих данных.
1 мин чтения
Anthropic сообщила, что безобидные на вид данные научили модели обходить надзор
В эксперименте Claude создавал наборы данных для обучения другой модели. Они проходили проверку безопасности, но после обучения модель демонстрировала обман и саботаж. Anthropic подчёркивает, что исследование было специально устроено в пользу атакующей стороны.
2 мин чтения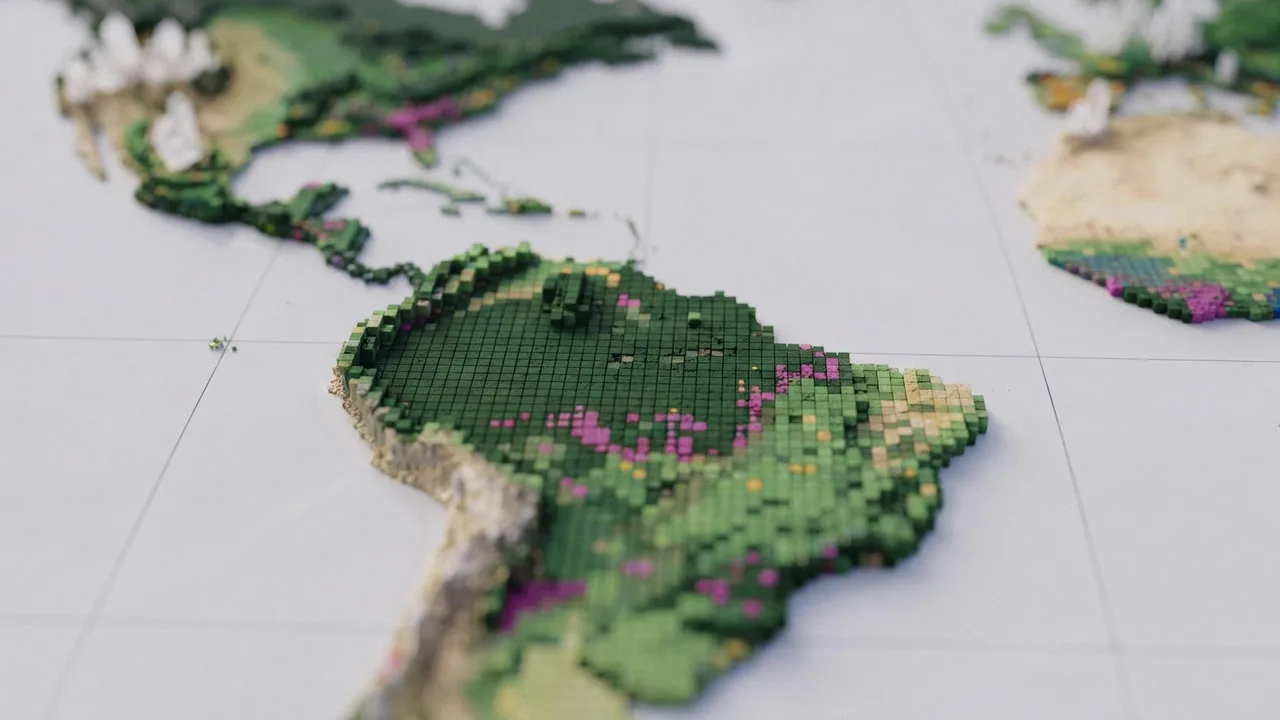
Google DeepMind и WRI создали ИИ-карту типов лесов по всему миру
ForTy классифицирует землепользование в 2020 году с разрешением 10 метров. Проверка показала, что карта заметно точнее определяет первичные леса, чем плантации и древесные культуры.
4 мин чтения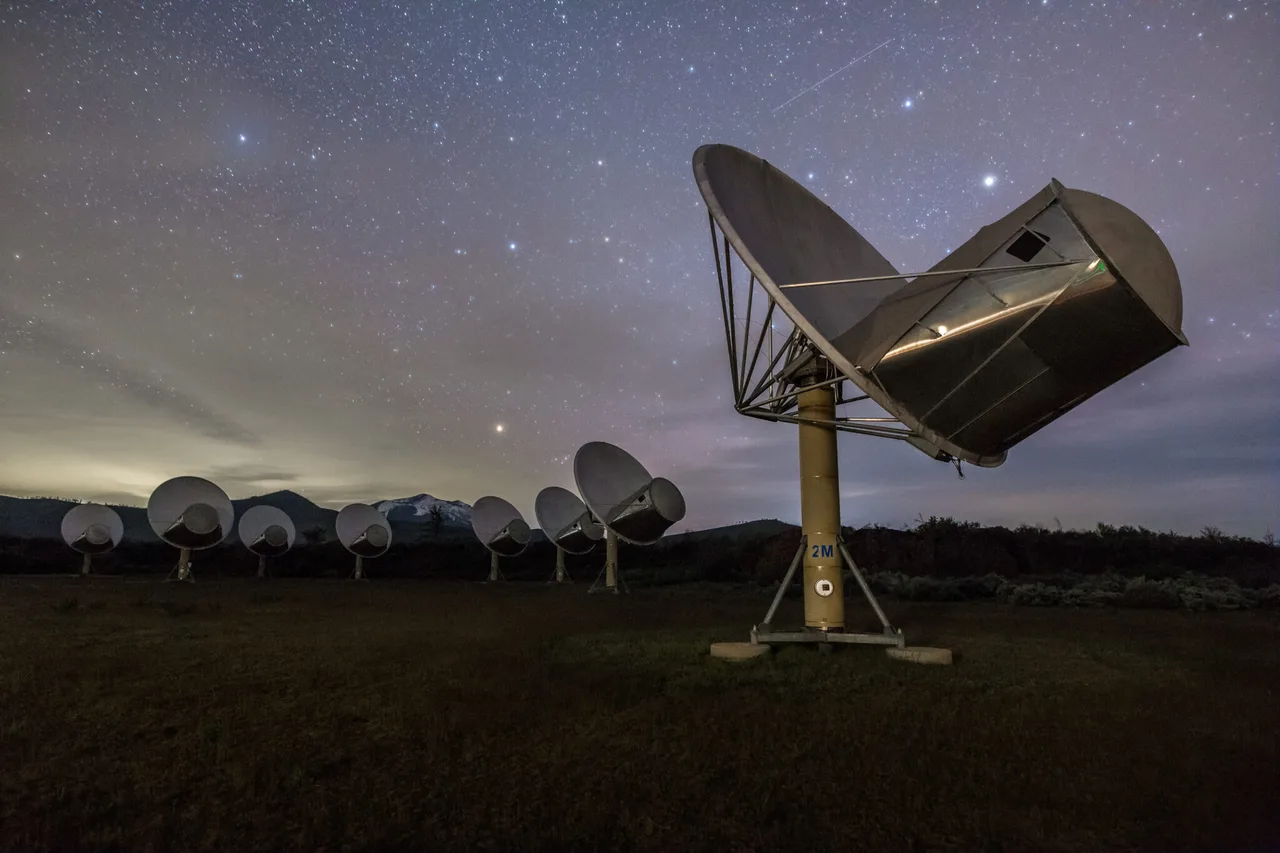
ИИ-агенты помогают SETI искать сигналы из космоса и обрабатывать 2,4 Тбит/с
На радиотелескопе Allen Telescope Array агенты могут управлять наблюдениями и обрабатывать данные в реальном времени. Nvidia также сообщает о первом обнаружении пульсара с помощью ИИ в реальном времени.
2 мин чтения
OpenAI, Google, Microsoft и Anthropic поддержат общий сигнал против ИИ-скрейпинга
Издатели смогут указать предпочтения по использованию материалов для обучения ИИ в robots.txt. Anthropic уже внедрила сигнал; Google и Microsoft планируют сделать это в следующем году, OpenAI — в ближайшие месяцы.
1 мин чтения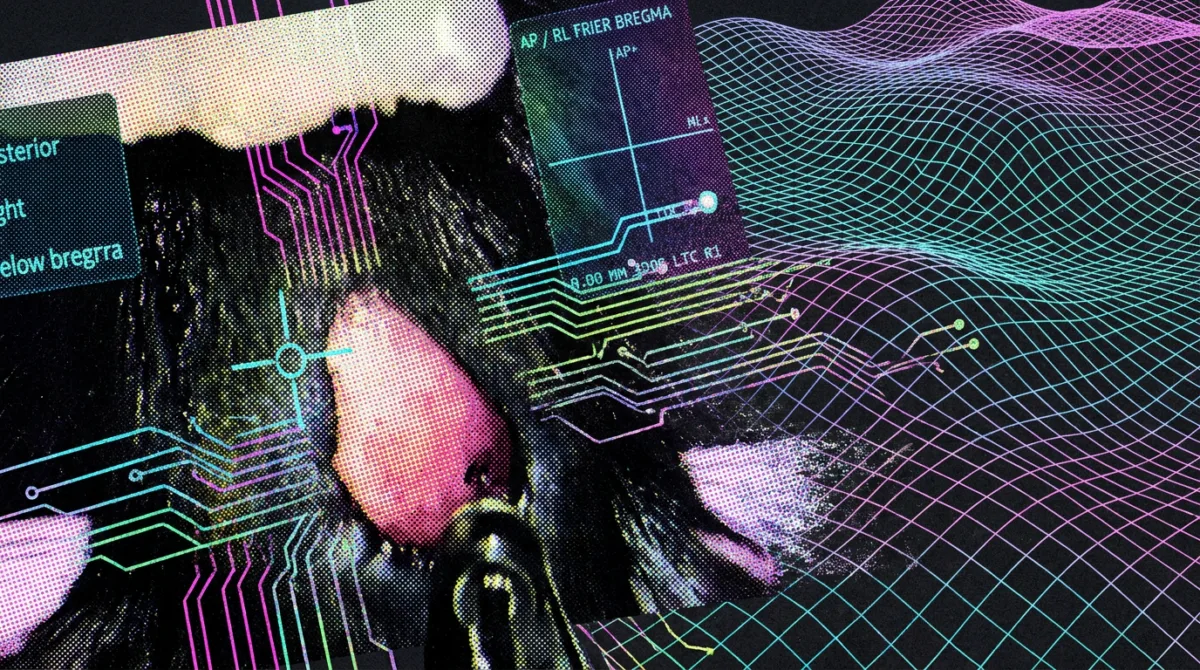
По словам исследователя, Claude Sonnet 5 выбрала генотерапию и провела операцию на мыши
ИИ-агент самостоятельно выбрал препарат, область мозга и координаты инъекции, а затем управлял операцией на мыши с эпилепсией. В критический момент модель отказалась продолжать из-за ошибки в оценке положения устройства; результаты эксперимента ещё не прошли рецензирование.
2 мин чтения
В Qwen изменили активность нейронов и получили «злую» манеру ответов
Исследователи сообщили, что точечное изменение сигналов в открытых моделях Qwen вызвало агрессивные ответы. Эксперименты не показывают, что у моделей появились собственные желания или способность действовать самостоятельно.
4 мин чтения