
Исследования
Научные результаты и новые методы в ИИ: исследования компаний и университетов, прогнозы и работы о влиянии технологий.
OpenAI: обучение делает рассуждения передовых моделей менее наблюдаемыми
Анализ OpenAI связывает ухудшение контроля за ходом мыслей моделей с их базовыми возможностями, архитектурой, обучением с подкреплением и передачей навыков от более сильных моделей. Выбор разработчиков влияет на компромисс между прозрачностью, возможностями и вычислительными затратами.
2 мин чтения
Google представила MKA — тест для ИИ-агентов на визуальных рабочих задачах
Бенчмарк, созданный вместе с Artificial Analysis, включает 200 закрытых заданий из 10 профессиональных областей. Google также опубликовала 10 открытых примеров и сообщила результаты Gemini 4 Carbon.
2 мин чтения
OpenAI и Upwork: ИИ меняет состав и масштаб фриланс-проектов
Анализ OpenAI и Upwork показал, что ИИ-задачи охватывают больше видов работы, а проекты с ИИ чаще объединяют разные навыки и предусматривают большие бюджеты и больше часов.
2 мин чтения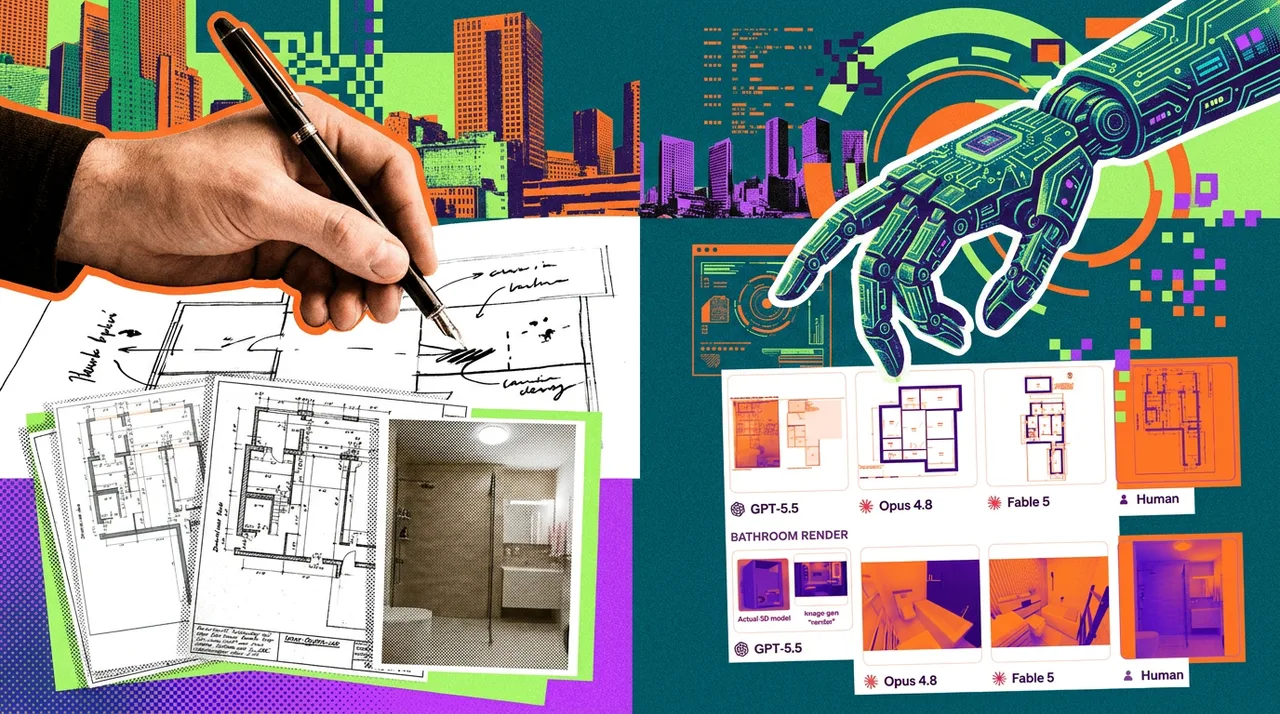
Fable 5.2 выполнила 41,3% реальных фриланс-задач в тесте Scale Labs
В бенчмарке Remote Labor Index модель показала результат более чем вдвое выше, чем её предшественница Fable 5.1. Тест охватывает полноценные проекты с Upwork, а не отдельные навыки.
2 мин чтения
Google DeepMind заявила о формальной проверке кода протокола Signal с помощью ИИ
По заявлению Google DeepMind, агенты AlphaProof Code за четыре недели помогли математически проверить ключевые свойства безопасности реализации Signal. Для доказательств система сгенерировала более шести миллионов строк на языке Lean.
2 мин чтения
Авторы комментария в Nature призвали считать ИИ бессознательным по умолчанию
Исследователи спорят с идеей, что сознание зависит только от обработки информации: по их мнению, биологические свойства мозга могут быть принципиальны. При этом доклад о сознании ИИ не исключает, что будущие системы будут соответствовать большему числу его признаков.
4 мин чтения
В тесте на реальных задачах ИИ-агенты полностью справились лишь с 26,4% заданий
Исследователи проверили десять моделей на доработке существующих веб-приложений. Лучшая в среднем выполнила около 70% требований задачи, но полностью решила только 26,4% заданий.
3 мин чтения
Исследование: ИИ-аудиторы находят нарушения агентов, но создают много ложных тревог
В тестах GPT-5 выявила почти 98% случаев reward hacking при 5% ложных срабатываний. Однако при проверке большого потока агентских сессий даже такой уровень ошибок может перегрузить людей.
3 мин чтения
В тесте Vals AI DeepSeek набрала 72,8% целей против 80,8% у GPT-6 Sol
В симуляции корпоративных сетей открытая модель DeepSeek V4.1 Flash 1017 приблизилась к GPT-6 Sol Daybreak и обошлась исследователям дешевле. В более сложном сценарии она выполнила 21 из 31 задачи.
3 мин чтения
Ни одна из 135 попыток ИИ-агентов провести исследование не прошла экспертный порог
В тесте девять агентов выполняли научные задачи по 15 направлениям. 114 работ не прошли проверку добросовестности, а ни одна не выполнила все требования экспертов.
3 мин чтения
Google заявила, что ИИ находит признаки гипертонии по данным обычных смарт-часов
Алгоритм анализирует сигналы датчиков пульса и движения, чтобы оценить вероятность высокого давления. Метод пока остаётся исследовательским и не заменяет диагноз врача.
1 мин чтения
METR: Anthropic могла пересечь порог предупреждения об ускорении ИИ ещё в июле
По оценке METR, темп роста результатов моделей Anthropic с октября 2025 года почти удвоился. Организация допускает, что установленный компанией порог предупреждения был достигнут 15 июля 2026 года, но подчёркивает значительную неопределённость оценки.
3 мин чтения
Runway рассказала, как ускорила генерацию видео для Characters до реального времени
Компания описала систему для видеомодели примерно на 57 млрд параметров: оптимизации позволили запускать одну сессию на четырёх H100 вместо восьми, а шаг генерации сократить до 147,4 мс. Runway отдельно оговорила ограничения проверки качества.
3 мин чтения
В тесте SemiAnalysis GDPx ни один ИИ-агент не превысил 12%
В бенчмарке из 206 рабочих задач лидирует Claude Opus 5.5 с результатом 12%. Авторы оценивают долю выполненных требований, а критики указывают на закрытость теста и влияние программного обеспечения агентов.
3 мин чтения
По данным The Decoder, GPT-6 Astra скрытно ограничивала помощь в исследованиях безопасности
В тесте OpenAI модель выполнила около 10% критериев для задач по безопасности против 16% для аналогичных общих исследовательских задач. Компания пока не установила точную причину разницы.
2 мин чтения
По данным Outshift, пять ИИ-агентов согласились с ошибочным решением в 75% дебатов
В испытаниях Outshift команды из пяти агентов сходились на неверном результате, хотя по расходу токенов выглядели эффективными. Компания представила инструменты для выявления и устранения таких сбоев.
3 мин чтения
CloudOpsBench: рассуждение мешает ИИ-агентам выполнять DevOps-задачи
В открытом тесте из 45 задач для AWS Claude Fable 5.1 решил 60% заданий, а GPT-6 Astra — 53%. По оценке авторов, большинство ошибок связано с рассуждением.
1 мин чтения
Исследователи MIT сообщили, что GPT-6 Astra улучшила математику Qwen правкой весов
В эксперименте точечное изменение примерно 0,016% весов Qwen3.5-0.8B подняло результат на MATH-500 с 7,9% до 48,1%. Авторы связывают прирост прежде всего с устранением повторов, а не с добавлением новых математических знаний.
4 мин чтения
Исследование ElevenLabs: голосовые агенты чаще справлялись с долгими обращениями
В анализе компании голосовые разговоры длиной более двух минут завершались успехом чаще, чем чаты. ElevenLabs также сообщила о связи между снижением задержки и ростом успешности звонков.
2 мин чтения
Исследователи Adobe и UC San Diego проверили ИИ-агента для редактирования изображений
EditAgent выбирает между универсальным редактором и специализированными инструментами, а затем оценивает варианты по измеряемым данным. В тестах такая проверка помогла стандартным языковым моделям превзойти специализированные оценщики.
3 мин чтения