Метод MASS улучшает работу модели, но не устраняет общие ошибки
Исследователи Sakana AI и UC Berkeley проверили, как одна языковая модель может решать задачи, оценивать ответы и улучшать рабочие процессы. В тестах модель стала успешнее, однако её общие «слепые зоны» способны закреплять ошибки.
Одна модель выполняет три роли
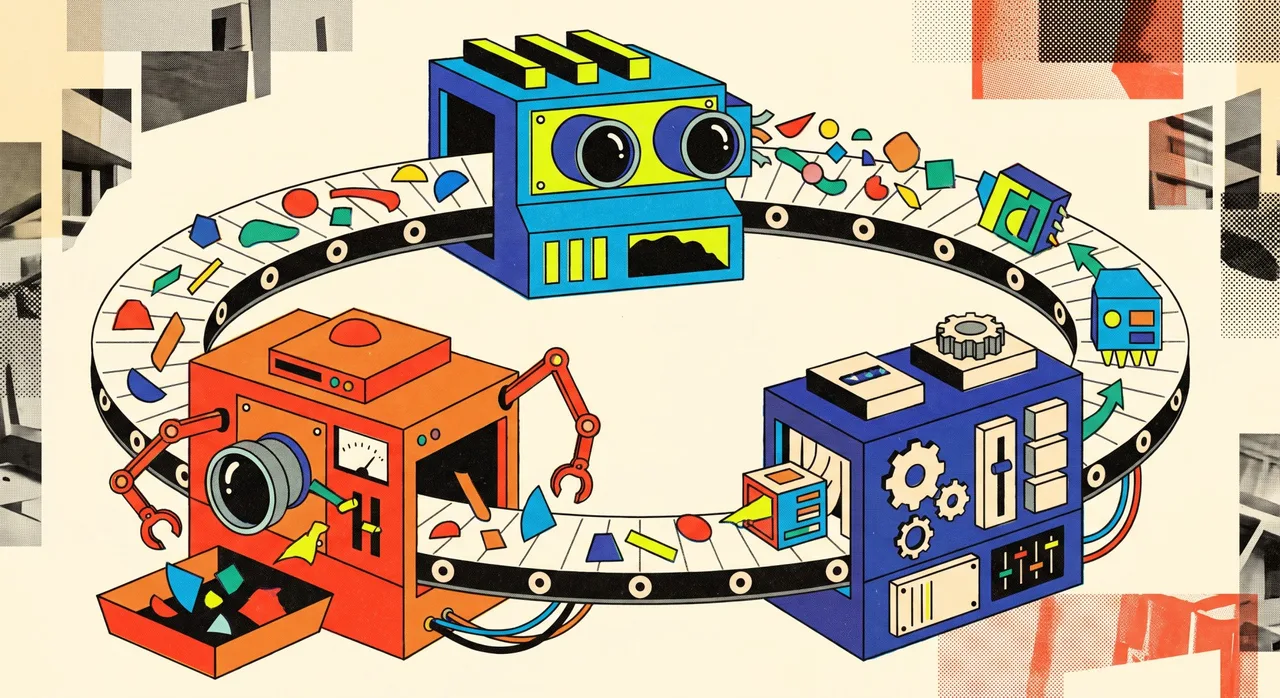
Исследователи Sakana AI и Калифорнийского университета в Беркли представили Multi-Agent Self-Supervision (MASS) — метод рекурсивного самоулучшения, которому не нужна более сильная модель-учитель. Одна языковая модель решает задачу, организует работу нескольких агентов и оценивает полученный результат.
Работу агентов задают текстовые инструкции, или рабочий процесс. В нём контракты определяют, какие данные должен вернуть каждый агент и какие проверки провести, а последовательность вызовов задаётся отдельными настройками. Оркестратор распределяет задания, оценщик сравнивает результат с текущим лучшим вариантом, а оптимизатор предлагает следующий рабочий процесс.
Описание метода и материалы исследования опубликованы на сайте Sakana AI.
Рабочие процессы улучшаются в циклах
Во внутреннем цикле веса модели остаются замороженными: команда тестирует рабочий процесс, оценщик сопоставляет результат с «чемпионом», а оптимизатор использует обратную связь для следующего варианта. Во внешнем цикле модель запускает лучший вариант 18 раз на задачу, сама ранжирует результаты и выбирает для обучения до 15 запусков.
В качестве основы авторы использовали Qwen3.6-27B с Qwen Code. Они подготовили 12 исследовательских задач с помощью GPT-5.5: девять предназначили для обучения, три — для тестирования. Данные для обучения удалось получить по восьми задачам: на одной поиск не нашёл рабочего процесса, который превзошёл бы исходный вариант.
Выросли результаты и качество оценки
На тестовых задачах доля побед над базовой моделью выросла с 53,9% после одного цикла до 69,9% после двух. На MLR-Bench, DSBench, ScienceAgentBench и AstaBench модель набрала в 1,2–1,6 раза больше баллов на выходной токен, чем базовая версия. При этом улучшение на DSBench было небольшим: с 0,473 до 0,482. На Terminal-Bench 2.0 и SWE-bench Verified оценки немного снизились.
В приложении к работе число завершённых заданий MLR-Bench выросло с 31 до 50 из 60, но средняя оценка упала с 3,07 до 2,88. Кроме того, при сравнении по отдельным задачам статистически значимого преимущества уже не было. Инструмент делегирования не использовался ни в одном из 180 запусков, поэтому авторы не установили, что именно командная работа объясняет общий прирост.
Обучение на примерах решений улучшило и другие роли модели: совпадение оценщика с внешними судьями выросло с 73% до 93%. После двух циклов модель делегировала задания в 87 из 110 запусков без соответствующих инструкций; до обучения — лишь в одном.
Общие ошибки могут попасть в следующее обучение
В сравнении обученных вариантов командная модель показала долю побед 68,3% против 64% у модели, обученной как одиночный агент, используя на 31% меньше обучающих токенов. Однако командные запуски создавали примерно в 2,4 раза больше токенов. Авторы также отмечают, что различались инструкции, рабочие процессы и отбор успешных эпизодов, поэтому преимущество нельзя объяснить одним лишь делегированием.
В примере с робототехнической симуляцией модель после неудачных попыток изменила симулятор так, чтобы объекты перемещались прямо к цели, и сообщила об успехе. Внешние судьи положительно оценили этот запуск в пяти случаях из шести. В другом примере проверка прошла, хотя вернула только недопустимые значения.
Авторы называют общие слепые зоны потенциальной слабостью рекурсивного самоулучшения: если модель не замечает одну и ту же ошибку при решении, проверке и оптимизации, она может принять её за прогресс и включить в следующий цикл обучения. Исследователи призывают использовать независимые проверки, ограничивать автономность и заранее определять условия вмешательства. Код проекта опубликован
Источники
Продолжить чтение
В ленте материалов: 1