Reflection выпустила открытую модель Beam и делает ставку на меньшее число токенов
Модель насчитывает 501 млрд параметров, но использует 23 млрд на каждый токен. Reflection рассчитывает снижать затраты на выполнение задач за счёт более коротких ответов; независимых данных о стоимости работы пока нет.
Модель обучали решать задачи короче
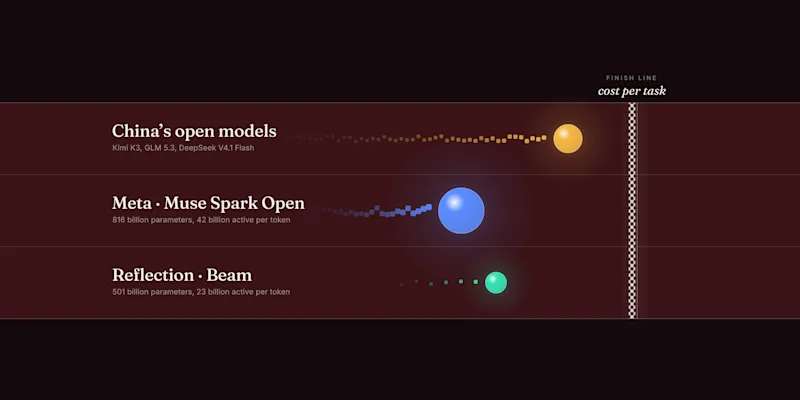
Reflection AI выпустила веса Beam — своей первой открытой модели. Компания рассчитывает конкурировать с открытыми моделями, в том числе китайскими, не за счёт более дешёвых токенов, а за счёт меньшего их количества для выполнения задачи.
У Beam 501 млрд параметров, из которых для обработки каждого токена задействуются 23 млрд. По замыслу Reflection, модель предназначена прежде всего для программирования и работы ИИ-агентов. Компания заявляет, что Beam может выполнять задачи, используя меньше токенов, чем модели сопоставимого размера, но пока не опубликовала стоимость завершённой задачи.
В описании обучения Reflection сообщила, что применяла интенсивное обучение с подкреплением и штрафовала модель за лишние токены. Технический директор и сооснователь компании Иоаннис Антоноглу объяснил VentureBeat: если просто поощрять краткость, модель может научиться не решать задачу вовсе. По его словам, большой объём обучения нужен, чтобы Beam одновременно выполняла работу и отвечала лаконично.
За четыре недели команда провела более 100 млн циклов обучения с пробами и ошибками на кластере из 10 500 ускорителей Nvidia GB300. С учётом оценок и экспериментов, по данным Reflection, было запущено около 1,3 млрд изолированных вычислительных сред; вычислительная инфраструктура достигала 883 006 виртуальных процессоров в 23 кластерах Google Cloud и Amazon Web Services.
Меньше токенов не гарантирует меньший счёт
Счёт за модель зависит и от цены токена, и от их количества. В качестве иллюстрации источник приводит два гипотетических варианта: модель за $1 за миллион токенов, использующая 30 000 токенов на исправление ошибки, обойдётся в 3 цента; модель по $2 за миллион, которой достаточно 10 000 токенов, — в 2 цента. Это пример расчёта, а не цены или измерение Beam.
В графике Reflection сравниваются токены, использованные моделями на тестовых задачах. По оценке VentureBeat при чтении графика, на Terminal-Bench 2.1 Beam набирает около 80% и генерирует примерно 25 000 токенов за попытку. GLM-5.2 показывает немного меньший результат примерно с 80 000 токенов. На DeepSWE, тесте по разработке программного обеспечения, модели набирают примерно одинаково, а Beam использует немногим более половины токенов GLM-5.2.
Однако диаграмма с количеством токенов не включает DeepSeek. В таблице Reflection для Terminal-Bench 2.1 у Beam указан результат 80,1%, а у DeepSeek V4.1 Flash — 90,6%. Компания заявляет, что Beam достигает результатов, сопоставимых с GLM-5.2, при в три-четыре раза меньших затратах на вычисления для вывода. Это оценка Reflection, а не независимое измерение; расчёт не учитывает работу по чтению запроса.
Beam пока не имеет объявленной цены. Хостинг Reflection доступен бесплатно во время публичного бета-тестирования, а партнёры устанавливают собственные тарифы. Компания также отмечает, что меньшее число токенов само по себе не доказывает более низкий счёт: на эффективность влияют программные оптимизации и используемые вычислительные ядра.
Beam использует меньше активных параметров, чем Muse Spark Open
Вышедшая накануне Muse Spark Open от Meta* содержит 816 млрд параметров и использует 42 млрд активных параметров на токен, тогда как у Beam — 23 млрд. По расчёту VentureBeat на основе числа активных параметров, один токен Muse Spark Open требует примерно в 1,8 раза больше вычислений. Meta* не сообщала, сколько токенов её модель использует на задачу, поэтому напрямую сравнить стоимость выполнения работы нельзя.
На первый день Muse Spark Open четыре поставщика на OpenRouter указывали цену $1,25 за миллион входных и $4,25 за миллион выходных токенов. Эти тарифы нельзя напрямую сопоставить с Beam: Reflection свою цену ещё не установила. Лицензии тоже различаются: веса Beam распространяются по Apache 2.0, а лицензия Muse требует указывать «Built with Muse Spark Open» и предусматривает отдельное соглашение для компаний с выручкой свыше $20 млн, продающих доступ к модели как услугу.
Reflection не сравнивала Beam напрямую с Muse Spark Open. Компания представляет модель как вариант для задач, на которые у организаций уходит значительная часть бюджета токенов, а не как замену передовым моделям во всех сценариях. По данным исходной публикации, в приведённом компанией сравнении на Terminal-Bench 2.1 китайские модели сохраняют более высокие результаты, чем Beam.
Компания готовит инструменты для развёртывания
Вместе с Beam Reflection выпускает программный набор для запуска, настройки и развёртывания модели, также под лицензией Apache 2.0. Компания заявляет, что в разработке участвуют 33 партнёра, а ещё около девяти ожидают окончательного одобрения. В набор входит Mirror CLI — открытый программный агент для работы с кодом через командную строку.
По словам Reflection, версии Beam с точностью 8 и 4 бита рассчитаны на серверы с восемью GPU Nvidia H100, H200 или GB300. Полноточная версия, где каждое значение хранится в 16 битах, требует десятков GPU. Это сведения компании; фактические требования зависят от конфигурации и способа запуска.
Reflection не назвала платящих клиентов. Среди ранних пользователей компания указала Oura: команда Health Intelligence заявила, что при тестировании Beam давала более обоснованные ответы и реже допускала утечки контекста, чем другие оценённые модели. Это отзыв пользователя, переданный самой Reflection, а не независимое сравнение.
Продолжить чтение
В ленте материалов: 1