
Программирование
ИИ в программировании: помощники и агенты для кода, модели для разработчиков, практика и ограничения.
Anthropic сообщает, что Opus 5.5 дешевле для длинных сессий Claude Code
По внутренним данным Anthropic, с марта по сентябрь 2026 года контекст в запросах Claude Code вырос в 2,6 раза, а пользователи чаще подключали инструменты и навыки. Компания объясняет экономию Opus 5.5 более низкими тарифами и улучшенным использованием кэша.
2 мин чтения
Cursor выпускает ботов для контроля релизов и проверки безопасности кода
Rollouts отслеживает изменения от pull request до production и предлагает действия при регрессии, а Security Reviewer ищет уязвимости в контексте кодовой базы и предлагает исправление. Cursor сообщает, что оба инструмента доступны на планах Teams и Enterprise.
2 мин чтения
Cursor снизила расход токенов агентами на 7% без потери качества
Агенты Cursor стали дольше работать и переносить больше контекста между шагами. Чтобы снизить расходы, компания изменила способ подготовки запросов, повторного использования контекста и распределения задач между агентами. Системную инструкцию — правила,…
1 мин чтения
В Anthropic объяснили, почему новые Claude могут писать менее естественно
Инженер Anthropic Джексон Кернион связывает менее естественный стиль Claude с оптимизацией под код и технические объяснения. По его словам, Opus 5.5 нашла лучший баланс, но проблема не решена.
1 мин чтения
OpenAI представила GPT-6 Sol и Luna по цене вдвое ниже
OpenAI выпустила GPT-6 Sol и GPT-6 Luna — более доступные модели для типовых корпоративных задач.
2 мин чтения
Anthropic объяснила, из чего складывается цена задачи в Claude Code
Anthropic показывает, почему цена задачи зависит не только от тарифа за токен: каждый новый ход повторно отправляет часть контекста, кэширование снижает стоимость чтения, а рассуждения тарифицируются как выходные токены.
2 мин чтения
SpaceXAI использует Grok Bot для обработки обращений службы поддержки
По данным компании, после объединения команд число тикетов выросло на 175%, а новых сотрудников нанимать не пришлось. Внедрение шло от внутренних заметок с обязательным одобрением до ответов клиентам, но экономия и эффект — внутренняя оценка SpaceXAI.
2 мин чтения
Anthropic выпустила Claude Opus 5.5 с более низкой ценой и меньшим расходом токенов
Anthropic утверждает, что новинка сопоставима с Fable 5.1 на большинстве задач и обходится примерно на 40% дешевле предшественника Opus 5. В бенчмарках модель лидирует по ряду сценариев, но GPT-6 Astra опережает её в автоматизации и научных исследованиях.
2 мин чтения
OpenAI расширила Academy курсами для разработчиков, руководителей и преподавателей
OpenAI добавила в Academy новые образовательные траектории для технических команд, руководителей, преподавателей и студентов. В курсах предлагают практиковаться на рабочих и учебных задачах, а освоение подтверждать оценочными заданиями и значком Academy.
2 мин чтения
xAI выпустила Grok 4.7 для длительных задач программирования и работы с документами
xAI заявляет об улучшениях на длинных задачах и более сильной защите от jailbreak. В benchmark-максимумах Grok 4.7 обошла Grok 4.6 по нескольким направлениям, но уступила конкурентам в ряде тестов, включая клинические рассуждения и terminal work.
2 мин чтения
EnvHarness меняет тренировочные среды под слабые места ИИ-агента
Фреймворк сохраняет исходный симулятор и проверяющий, но меняет стартовые условия и доступные действия. В пяти бенчмарках улучшение на отложенных задачах доходило до 9 пунктов; для диагностики среда должна безопасно сбрасываться.
2 мин чтения
Unity выпустила официальные плагины для Claude Code и Codex
Пакеты дают агентам навыки для UI, 2D, URP, звука, физики и других задач движка. Версия для Codex начинается с 31 навыка, включая настройку проекта и перенос старых API.
1 мин чтения
Anthropic запустила Claude Code Projects для долгих задач разработки
Проект координирует несколько облачных сессий, хранит общее состояние и позволяет управлять работой со смартфона. Пока он не подключается к компьютеру разработчика и внутренним сетевым сервисам.
2 мин чтения
Claude Projects объединяет параллельные потоки работы и общую память проекта
Обновлённые Projects могут делить большую задачу между потоками Claude Code, каждому из которых выделяется отдельная облачная сессия и копия репозитория. Бета-версия сначала доступна части пользователей Pro и Max.
2 мин чтения
DarwinX подняла результат браузерного агента Salesforce с 43,5% до 93%
Фреймворк Salesforce меняет инструкции, инструменты и процессы агента, не переобучая модель. Авторы сообщают о росте результатов на четырёх тестах, но подчёркивают необходимость повторных запусков и проверок на регрессии.
2 мин чтения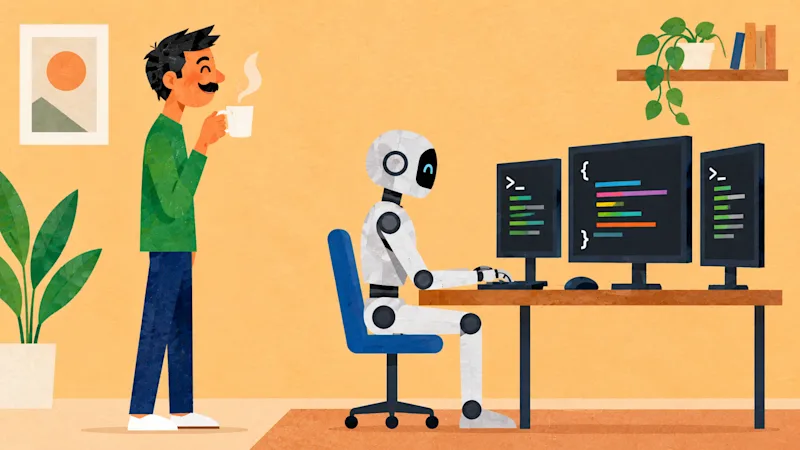
Доля разработчиков, поручающих ИИ половину кода, выросла до 42%
В опросе BairesDev разработчики сообщили, что ИИ помогает экономить 13 часов написания кода в неделю. Одновременно 67% стали больше проверять такой код, а 52% — чаще исправлять внесённые им ошибки.
2 мин чтения
G5 Labs представила платформу для координации корпоративных ИИ-агентов
Стартап Тима Краски вышел из скрытого режима с инвестициями 14 млн долларов. G5 превращает требования и решения компании в общую структурированную модель для сотрудников и агентов.
2 мин чтения
Рост ИИ-кода увеличил нагрузку Anthropic на CI в 25 раз
За полгода число CI-задач Anthropic выросло в 25 раз, а служба выбора тестов стала отставать. Компания переработала её в масштабируемую систему с очередью событий; выводы основаны на внутреннем опыте одной команды.
2 мин чтения
OpenAI открыла бета-версию Agents API для многочасовых задач
Новый API позволяет запускать облачных агентов, которые выполняют код, обрабатывают файлы и передают части работы субагентам. Разработчики выбирают хостинг OpenAI или партнёров; отдельной платы за API нет, расчёт идёт по токенам.
1 мин чтения
DeepSeek V4.1-Flash сокращает память KV-кэша для длинных задач
Модель на 552 млрд параметров поддерживает контекст до миллиона токенов. DeepSeek заявляет, что часть KV-кэша в GPU требует четверть памяти предшественника, но на тестах модель уступает в отдельных задачах и может расходовать в 2,5 раза больше токенов при глубоком рассуждении.
2 мин чтенияВсе материалы загружены