
Генерация аудио
Синтез речи, музыки и звука с помощью ИИ: новые модели, сервисы, клонирование голоса и связанные риски.
Из Repentance Plus удалили музыку, созданную ИИ
Nicalis убрала сгенерированные музыкальные файлы из The Binding of Isaac: Repentance Plus после того, как игроки обнаружили их в пародийном сегменте игры и начали оставлять негативные отзывы.
1 мин чтения
Google открыла Genie 4 разработчикам через Gemini API
Модель позволяет создавать интерактивные миры в разрешении 720p с частотой 24 кадра в секунду и синхронизированным звуком. Доступ также появился в Google AI Studio.
1 мин чтения
Suno добавила Visuals для создания видео к музыке с помощью ИИ
Функция Visuals создаёт клипы длиной до 15 секунд, подстраивает их под структуру песни и поддерживает синхронизацию губ. Она доступна в веб-версии Suno, приложениях для iOS и Android и требует отдельных кредитов.
2 мин чтения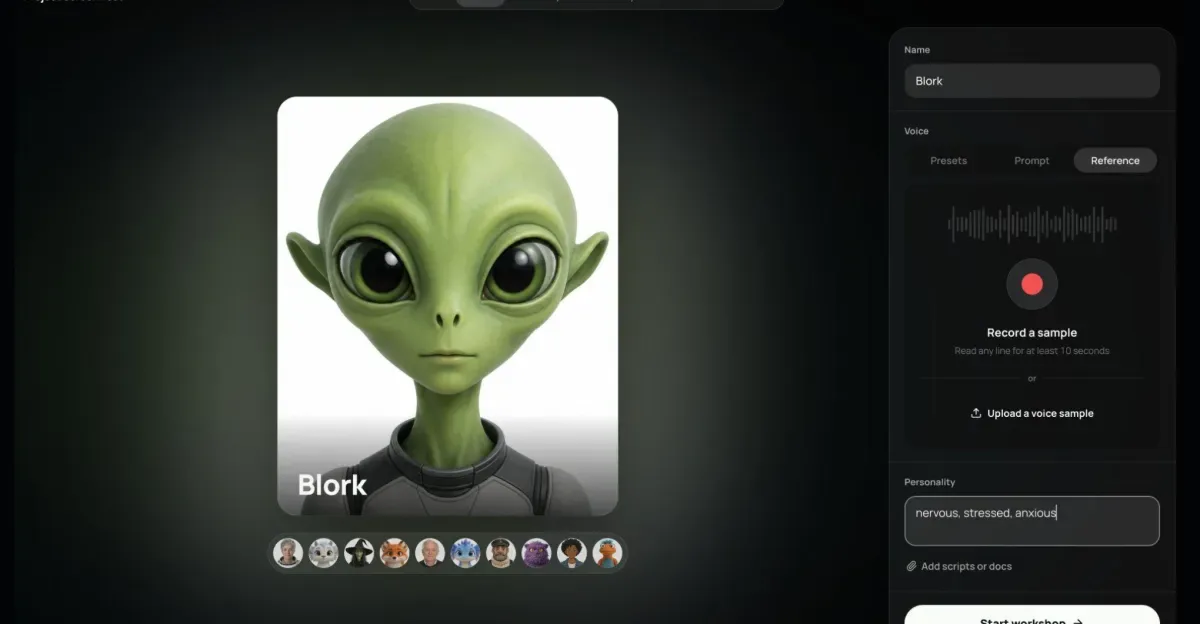
Adobe показала четыре экспериментальных ИИ-инструмента для фото, видео и звука
На Adobe Max представили проекты для создания персонажей через диалог, преобразования изображений в 3D-сцены, генерации звуковых эффектов и переноса правок в Photoshop. Это технологические демонстрации, и их выпуск не гарантирован.
3 мин чтения
Правообладатели Элвиса Пресли и издатель Эминема подали иски против Suno
Истцы утверждают, что музыкальный ИИ-сервис создает песни и тексты, имитирующие исполнителей. Представители Suno заявляют, что запрещают запросы с именами артистов и усиливают защитные меры.
2 мин чтения
SoundCloud добавил публикацию музыки из ElevenLabs
Пользователи ElevenLabs могут отправлять созданные треки прямо в SoundCloud. Публикации будут помечены как созданные с помощью ИИ, а подписчикам Artist Pro предложат три месяца ElevenMusic Pro бесплатно.
1 мин чтения
ElevenLabs выпустила модель звуковых эффектов SFX v3
SFX v3 доступна в ElevenCreative и через ElevenAPI. По данным ElevenLabs, модель лучше обрабатывает запросы с несколькими звуками и улучшает генерацию музыки и вокала.
1 мин чтения
Google выпустила Genie 4 для симуляции интерактивных миров
Модель генерирует миры продолжительностью до двух минут, добавляет аудио и позволяет менять происходящее текстовыми запросами. Пока Genie 4 доступна только доверенным тестировщикам в исследовательском режиме.
1 мин чтения
Spotify заявила, что убрала из рекомендаций более 50 млн AI-треков и спам-композиций
По словам компании, за последний год она изменила систему рекомендаций, чтобы чаще показывать музыку людей. Spotify также сообщила, что её редакторы не добавляют в подборки треки, распознанные как спам или AI-«слоп».
1 мин чтения
Kling AI выпустила версию 4.0 с Flash-вариантом и стереозвуком
Модель создаёт видео до 30 секунд за один проход, принимает до десяти ключевых кадров и поддерживает синхронизацию речи более чем на десяти языках. Упрощённая Kling 4.0 Flash ограничена разрешением 720p и роликами до 20 секунд.
2 мин чтения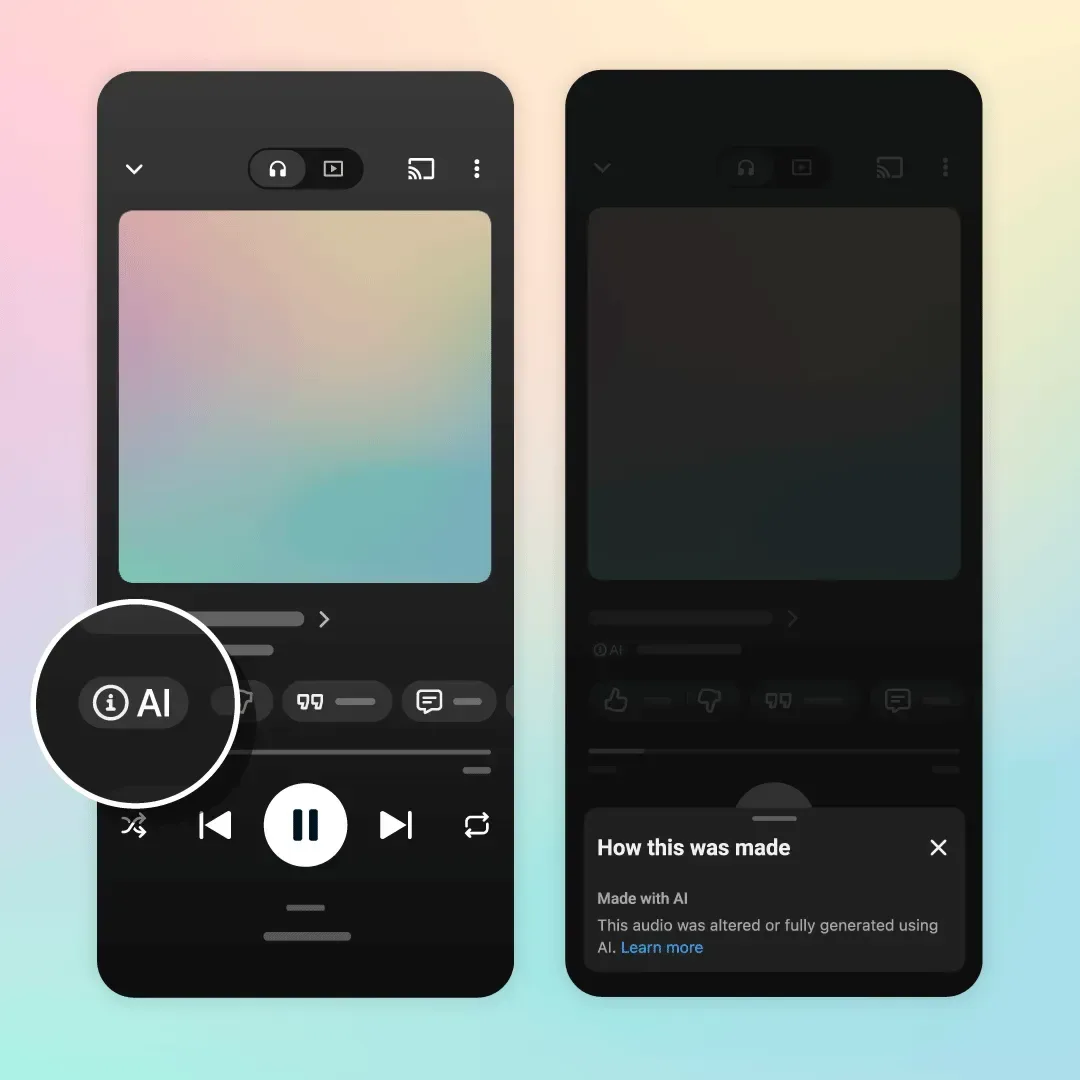
YouTube Music начнёт помечать треки, созданные с помощью ИИ
На музыкальной платформе YouTube появится метка «Создано с помощью ИИ». Она будет относиться к трекам, в создании которых генеративный ИИ сыграл значительную роль.
1 мин чтения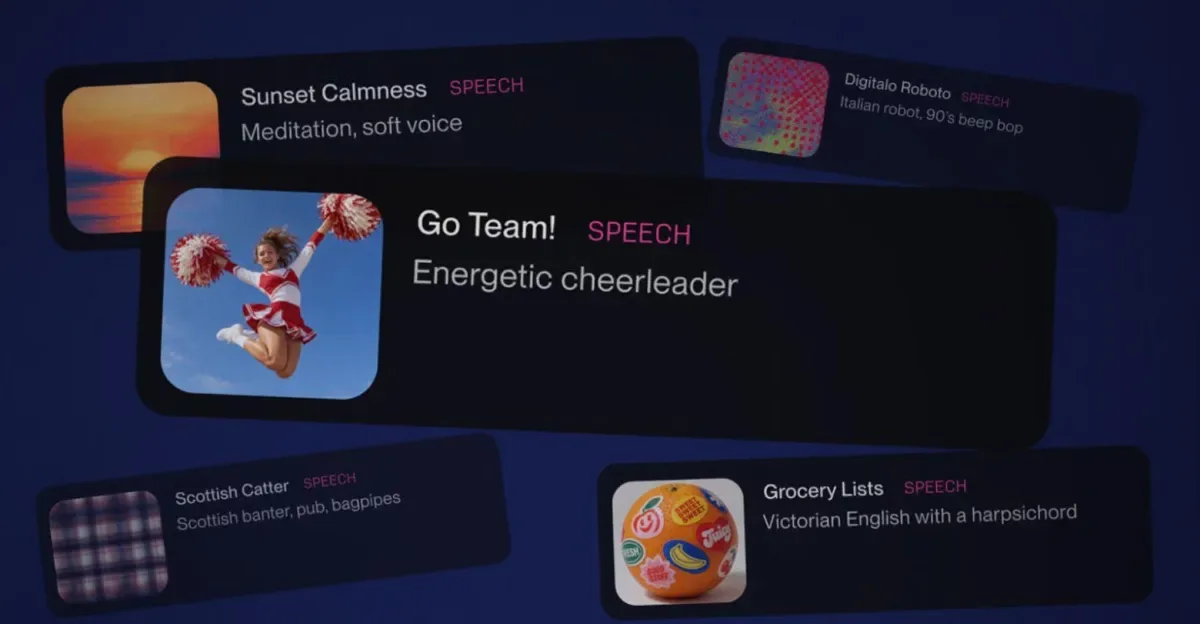
Suno добавила генерацию речи и фоновой музыки в одной дорожке
Speech доступна в публичной бета-версии на вебе и мобильных устройствах. Можно описать голос и сцену или задать текст; максимальная длительность — около восьми минут.
1 мин чтения
Eleven v4 точнее следует подсказкам и сохраняет голос в длинных проектах
ElevenLabs выпустила Eleven v4 с управлением эмоциями, паузами и произношением, заявив о более стабильных голосах в длинных проектах. Версия Turbo начинает воспроизводить речь примерно за 150 мс; модель также поддерживает более 90 языков.
2 мин чтения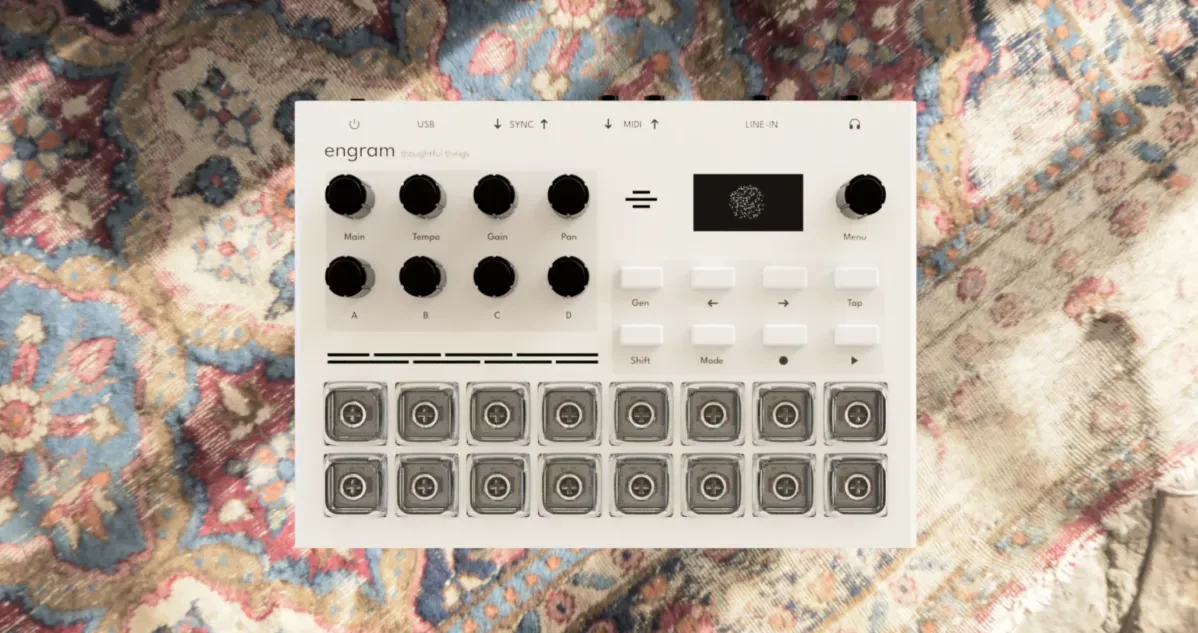
Engram превращает аудиосэмплы в экспериментальные звуки с помощью локальной AI-модели
Стартап Thoughtful Things запустил Kickstarter для автономного семплера и грувбокса. Устройство локально обрабатывает звук небольшой моделью; стартовый взнос начинается с 675 долларов.
2 мин чтения
Sony и UMG подали новый иск к Suno из-за обучения модели v6
Sony и Universal Music Group утверждают, что новая музыкальная модель Suno v6 нарушает авторские права.
1 мин чтения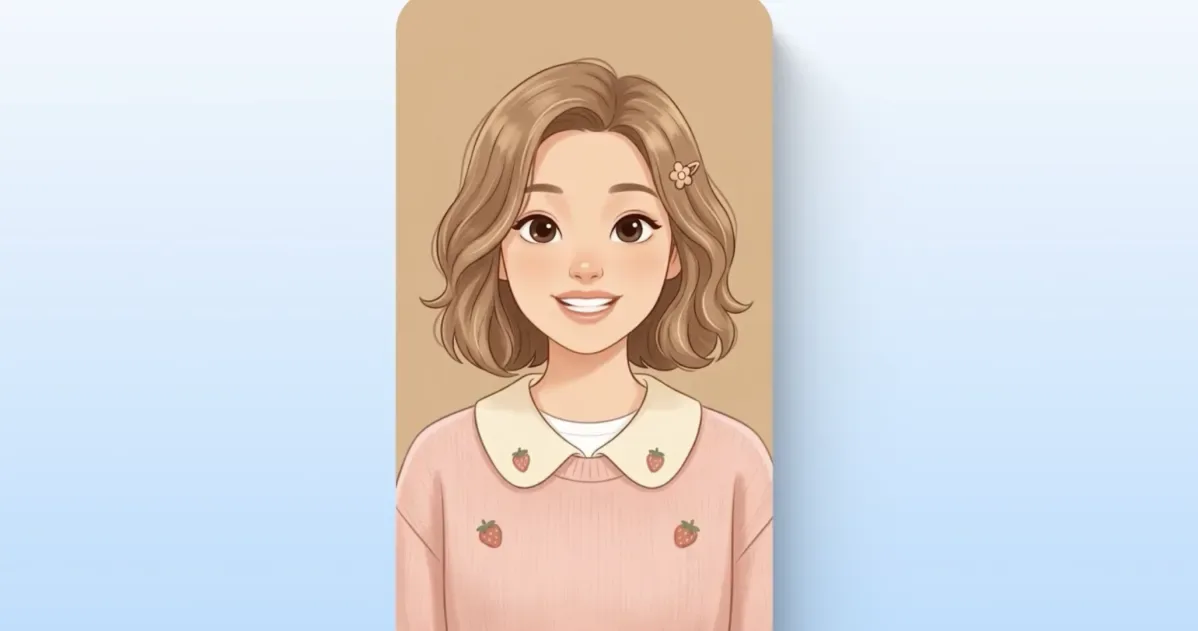
Google добавила в Gemini 3.8 Live говорящего аватара
Google представила Live Avatar — анимированного персонажа, который в реальном времени отвечает собеседнику: двигает губами в такт речи и меняет выражение лица.
2 мин чтения
Google представила две TTS-модели Gemini с генерацией голосов по текстовому описанию
Flash TTS создаёт голос с заданными ролью, акцентом и тембром; обе модели поддерживают более 100 языков и режиссёрские указания для отдельных реплик. Голосовой клон требует 30-секундный образец и записанное согласие владельца голоса.
2 мин чтения
Tencent представила Gander — голосовую модель для беседы и фоновых задач
В исследовательской модели отдельные компоненты отвечают за разговор и сложные агентные действия. Gander принимает видео, речь и текст и позволяет перебивать себя, но тесты показывают компромисс между временем реакции и точностью выполнения задачи.
1 мин чтения
Qwen3.8-Omni-Flash объединяет обработку аудио и видео и снижает цену API
Новая модель Qwen для ИИ-агентов принимает аудио и видео, имеет контекстное окно в миллион токенов и может вызывать инструменты. По сравнению с вводными тарифами Gemini 3.8 Flash её API стоит дешевле, однако сопоставление бенчмарков приводит сама Qwen.
2 мин чтения
xAI выпустила модель распознавания речи Grok Voice Transcribe 2.0
Компания заявляет, что новая версия вдвое точнее предшественницы при той же цене. В Artificial Analysis она заняла первое место среди 32 потоковых моделей.
2 мин чтения